#GraphForge:用真实文件和证据图给 Working Agent 造可验证的训练数据
论文:GraphForge: Training Working Agents with Graph-Anchored Workspace Synthesis(arXiv:2609.38923,2026-09-30)
作者:Qisheng Su 等(中科大、复旦、上海创新研究院、上海 AI Lab)
数据与模型:<https://huggingface.co/collections/groundhogLLM/graphforge>
#一句话说清这篇论文
训练"干活的 Agent"缺的从来不是模型,是数据——尤其是"建立在真实文件之上、结果可以被打分验证"的数据。GraphForge 的做法是:先抓一堆真实文件搭出工作区,再从文件之间的关系里"编译"出任务描述和评分标准,让每一条评分标准都能追溯到具体文件。用这套管线造出 2,169 条轨迹做 SFT + RFT,Qwen3.6-27B 在 GDPVal 上从 1380 涨到 1445.7 Elo(+65.7)。
#群里那条消息在说什么
推送原文有三句话,逐句拆开:
"前几天有群友提到 GDPVal 数据管线的问题" —— GDPVal 是 OpenAI 的基准,1320 个任务、44 个职业,用专家写的 rubric 给 Agent 产出的交付物打分,以 Elo 形式报告与人类工作的对比。它测的是"经济上有价值的真实工作",而训练这类能力的管线此前是空缺的。
"我们在训练 Working Agent 的时候,均使用复杂度更高的真实文件而非模型生成文件" —— 这是在和 EnvCraft 对比。EnvCraft 用模型生成文件,再用 Python 脚本检查工作区状态,但脚本读不了文档内容,文档类交付物的错误会被漏掉。GraphForge 坚持用真实抓取的文件。
"GraphForge 从真实职业任务出发,抓取多格式真实文件构建工作区,并通过构建文件关系证据图生成任务描述、交付要求和评分 rubric,使每条评价标准都能追溯到具体文件" —— 这是方法核心,下文详解。对应论文名称里的 "Graph-Anchored"(图锚定):评分标准的每个 criterion 都锚定(anchor)到证据图上的具体节点,也就是具体文件。
"Atria-Preview 在 GLM-5.2 基础上后训练后,在 Workspace-Bench 和 GDPVal 上均取得了提升" —— 注意:这条群消息与论文正文有出入。论文正文训练的是 Qwen3.6-27B 和 Qwen3.6-35B-A3B,Atria-Preview/GLM-5.2 只出现在论文的 Related Work 里被提及。管线本身(工作区构建、证据图、教师 rollout、judge)确实全部用 GLM-5.2 驱动,但没有"在 GLM-5.2 上后训练出 Atria-Preview"的实验。看群消息宣传时留个心眼,以论文为准。
#先定义几个名词
- Working Agent:不是聊天机器人,是像 OpenClaw、Hermes-Agent 那样的持久数字助理——读各种文件、调工具、跨文件系统/数据库/终端干活,最后交付别人能用的产物(报表、分析、报告)。
- GDPVal:OpenAI 的基准,1320 个任务、44 个职业,交付物由专家 rubric 打分,报 Elo。GDPVal-AA 是其中 220 题的金标子集。
- Workspace-Bench:把 Agent 放进有几万个文件的真实感工作区,考察跨文件依赖推理,细粒度 rubric 评分。
- Evidence Graph(证据图):GraphForge 的中间表示。节点 = 某个源文件 + 它提供的字段/事实 + 它在任务里的角色;边 = 跨文件依赖(解释、比较、对账、推导)。
- Rubric:评分细则。正分标准(做到了加多少分)+ 负分标准(出现禁止的行为扣分),每条带权重和验证流程。
- O*NET:美国劳工部的职业数据库,提供职业、任务陈述、详细工作活动(DWA)的受控词表和官方映射。GDPVal 的任务也来自同一词表——这是 GraphForge 审计污染时最紧张的地方。
#它想解决什么问题
Working Agent 的主流训练方式是拿强教师模型合成轨迹做 SFT。这要求任务建立在大量真实文件之上、结果可验证。两条现成的路都有硬伤:
| 文件来源 | 验证方式 | 硬伤 | |
|---|---|---|---|
| EnvCraft | 模型生成 | Python 脚本查工作区状态 | 文件缺乏真实性和多样性;脚本读不了文档内容,文档交付物的质量无法检查 |
| NexForge | 真实文件 | 无 | 没有任务专属的 rubric 或验证器,结果质量系统性失查 |
用"真实文件 + 无验证"或"假文件 + 弱验证"训出来的 Agent,学到的工作习惯是脆的。GraphForge 的主张:任务和验证都应扎根在真实文件里。
#方法:五步流水线
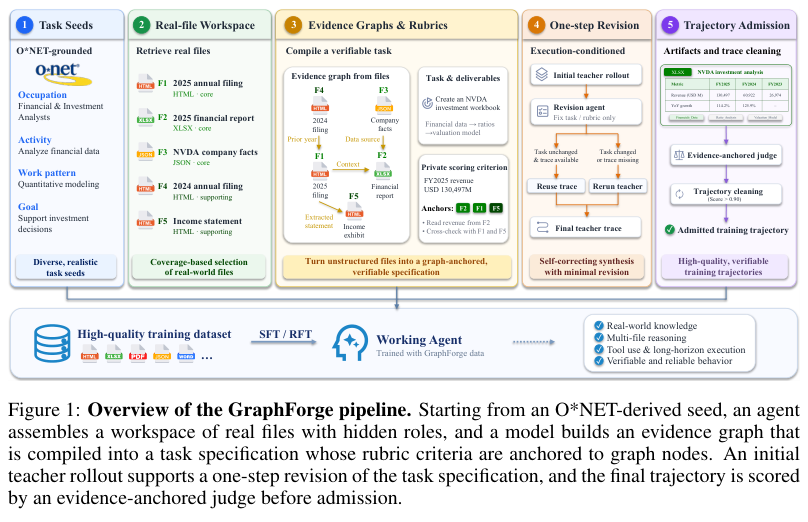
第一步:ONET 职业种子(控制多样性)。 让模型自由发挥编任务,会塌缩到高频职业和泛化任务类型(又是分析师、又是写报告)。GraphForge 反过来:种子先从 ONET 数据库里选,每个种子是一个六元组(职业 o,DWA 任务类型 a,职业需求 w,执行模式 p,输入文件族 u,检索到的职业证据 e)。只保留 AI4Work 标注为 DIGITAL 的任务。覆盖 246 个职业、16 个行业部门、891 种 DWA 任务类型。选种子时用边际覆盖贪心法——哪个维度(职业/任务类型/执行模式/文件族)欠代表就补哪个——保证语料不塌缩。
第二步:真实文件工作区(实例化)。 种子是"案例中立"的:它规定了谁干活、干什么、怎么干,但不指名公司、事件、数据集。一个搜索 Agent 为每个种子找一个连贯的公开案例,抓取干活所需的文件,按原生格式(PDF/XLSX/HTML/CSV/DOCX/JSON 等)下载、解析、去重。每个文件被赋予一个隐藏角色:core(驱动主计算/决策)、supporting(提供背景/政策)、confuser(貌似相关但实际用不上的干扰项)、ambient(纯冗余)。这些角色只给管线用,绝不给干活 Agent 看——干扰项是刻意设计的,模拟真实工作区里"桌面上一堆文件但只有几份有用"的状况。
第三步:证据图与可验证 rubric(本文灵魂)。 在工作区上建证据图:节点记录"哪个文件提供什么字段、在任务中扮演什么角色";边记录跨文件依赖。论文明确说:图不是 ground truth,只是中间表示,图上的每个声明都必须能从原始文件里恢复。图被编译成任务规范:自然语言任务陈述 q、交付要求 D、正分标准 R+、负分标准 R-。每条正分标准是一个六元组:目标交付物 d、要求 r、期望值/计算 z、权重 w、证据锚点 A(指向具体图节点)、验证流程 φ。关键设计是执行与验证分离:干活 Agent 只看到任务陈述和工作区(不知道锚点、不知道文件角色);judge 拿到锚点和验证指令,知道该去查哪些文件、哪些交付物部分。锚点既引导 rubric 生成也引导判分,但不把解题步骤泄漏进任务陈述。
第四步:执行条件化的一步修订。 静态检查抓不出长时程任务的所有歧义。所以每个任务规范先让强教师模型跑一遍,产出初始轨迹和交付物。修订 Agent 拿着原始文件、证据图、完整任务和 rubric、以及这次执行,检查:任务是否自然可执行?所需量是否有文件支撑?每条标准锚定是否正确?验证指令够不够?修订只返回需要改的部分,编译器保留其余字段。只有任务陈述变了才重跑教师(用任务陈述的归一化哈希判断);只改了 rubric 绑定就直接复用初始执行、按新规范重新判分——省钱。
第五步:产物级准入 + 轨迹清洗。 轨迹只有在"承诺的交付物真实落盘"后才准入:确定性检查(文件名、可读格式、必需的 sheet 和公式、结构约束),然后 agent judge 对照源文件和产物逐条打分。总分是"正分标准加权和(每条按完成比例 a∈[0,1])减负分项(按证据确认的违反程度 v 扣)"。准入线 Q > 0.90。此外还丢弃工具行为退化的轨迹:重复非轮询调用、工具调用过多、工具失败率高、反复截断。
#结果
#主表:SFT 大涨,且跨 scaffold 迁移
数字拆开看:
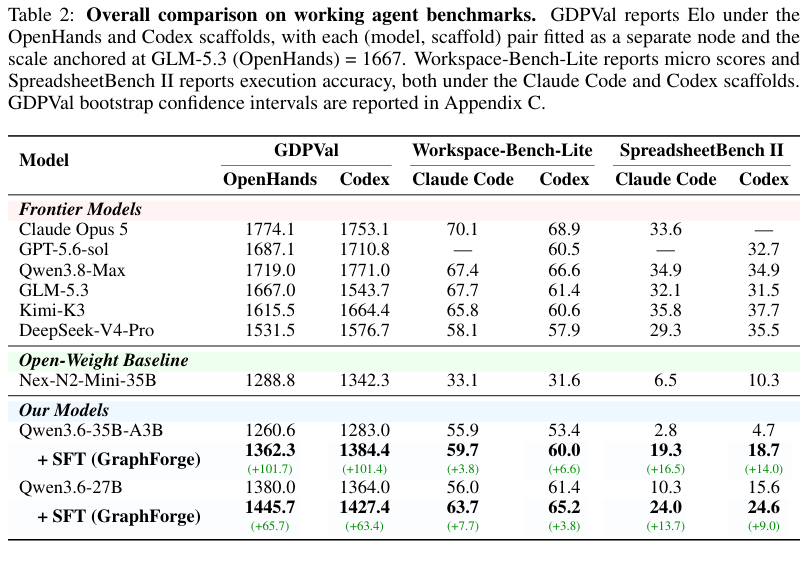
- Qwen3.6-27B + SFT:GDPVal 1380.0 → 1445.7(OpenHands,+65.7)/ 1427.4(Codex,+63.4);Workspace-Bench-Lite 56.0 → 63.7(Claude Code,+7.7);SpreadsheetBench II 10.3 → 24.0(Claude Code,+13.7)。
- Qwen3.6-35B-A3B + SFT:GDPVal +101.7 Elo(OpenHands),SpreadsheetBench II 2.8 → 19.3(+16.5)。同一份数据在两个底座上都涨,说明轨迹跨底座通用。
- 位置感:27B-SFT 的 1445.7 仍低于 Claude Opus 5(1774)、Qwen3.8-Max(1719)和 GLM-5.3(1667,锚点),但已大幅超过开放权重的 Nex-N2-Mini-35B(1288.8)。这是"27B 开源模型逼近一线闭源 working 能力"的量级。
- 跨 scaffold 迁移是个被低估的亮点:所有 GraphForge 轨迹用 Codex scaffold rollout,评测却覆盖 OpenHands、Codex、Claude Code 三个 scaffold,每个 scaffold 下都涨。学的是干活技能,不是绑定某个 rollout scaffold 的习惯。
#数据本身长什么样
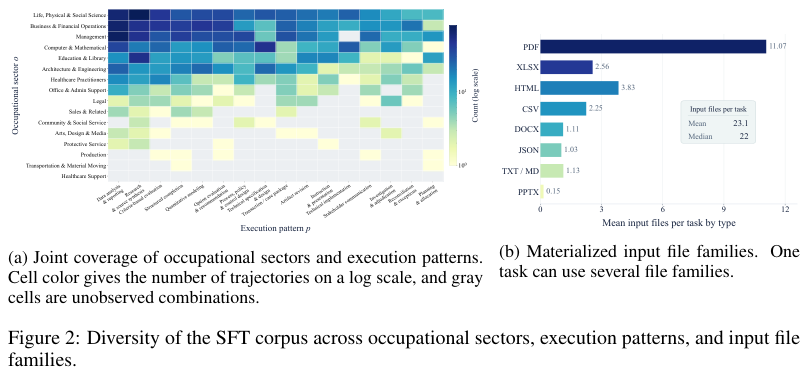
2,169 条准入轨迹覆盖 466 种 O*NET 任务类型、15/16 个职业部门、全部 16 种执行模式。PDF 出现在 96.7% 的轨迹里,平均每任务 23.1 个输入文件。数据分析和报告占 14.2%,研究综合占 13.2%,其余模式都不超 9%——形状来自真实职业需求加准入过滤,而非均匀采样。
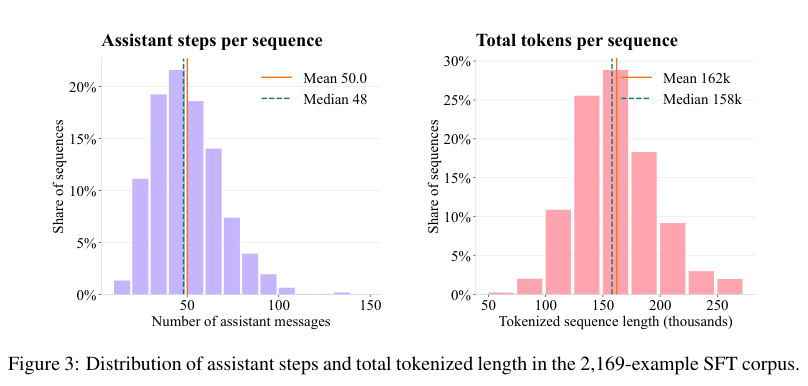
平均每条轨迹 50 个 assistant 步、162k token——这是货真价实的长时程工作轨迹,不是玩具对话。
#RFT 消融:证据锚定的选择信号
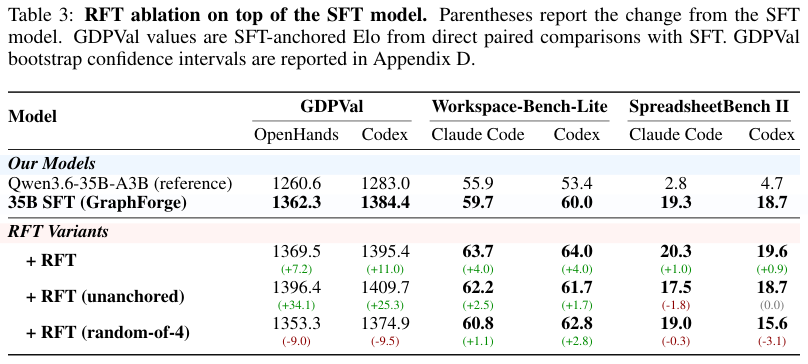
在 SFT 之上做拒绝微调(RFT):从 2,000 个新 query 里每个采 4 条 SFT 模型自己的 rollout,三种选法——anchored(judge 带证据锚点选最高分,阈值 0.95)、unanchored(judge 只看 rubric 文本不看锚点)、random-of-4(随机选)。三臂共享相同 query、候选池和预算。
结果:Workspace-Bench-Lite 和 SpreadsheetBench II 上顺序完全符合设计预期(anchored > unanchored > random,random 甚至净退步)。GDPVal 上 unanchored 点估计更高(+34.1 vs +7.2)但论文坦承 220 题的 Elo 差异统计上分辨不出来。诚实的读法:选择质量重要(random 一致最弱),证据锚定的优势在另两个基准上兑现,GDPVal 太噪。
#审计:judge 真的在读文件吗
这是我认为论文里最聪明的小实验。给 judge 做受控扰动:删掉某条标准引用的 worksheet,该标准分数平均掉 0.377,非目标标准几乎不动(平均 |ΔQ|=0.016)——judge 确实在读引用的证据、反应局部化到受影响标准。但行级/数值级/引用级的细粒度篡改只引起 <0.03 的变化,理想 judge 本该抓住。论文归因于 GLM-5.2 作为 agentic judge 的能力上限:结构性证据缺失抓得住,细粒度内容核对抓不住。这个自我认知很清醒。
#污染审计:和 GDPVal 同源也没撞车
GDPVal 和 GraphForge 的种子都来自 O*NET,重叠风险天然最高,所以做了三级审计:文件级(39,201 个训练文件 SHA-256 vs 260 个 GDPVal 文件,零共享)、文本级(top-20 相似 13-gram 对,无实质共享)、职业级(44 个 GDPVal 职业只有 13 个被训练覆盖)。再按职业覆盖拆分 GDPVal:未覆盖组(155 题)SFT 胜率 0.739 不低于覆盖组(65 题)0.692——涨的不是背题,是可迁移的工作技能。
#逐句翻译成更直白的话
| 群消息原句 | 人话 |
|---|---|
| "复杂度更高的真实文件而非模型生成文件" | 别人家用 AI 编的假文件练手,我们用网上真抓的财报、年报、JSON——脏、乱、格式多,才像真活儿 |
| "从真实职业任务出发" | 任务不是拍脑袋编的,是从美国劳工部职业库里按覆盖度挑的,防止训练数据全是"分析数据写报告"这一种 |
| "抓取多格式真实文件构建工作区" | 每个任务配一个 20 多个文件的文件夹,里面还故意混进看似有用实际没用不了的干扰文件 |
| "构建文件关系证据图" | 先搞清楚哪个文件提供什么数、谁和谁要对账,画成一张图 |
| "生成任务描述、交付要求和评分 rubric" | 任务书和评分表都从这张图里编译出来,不是另写一套 |
| "每条评价标准都能追溯到具体文件" | 打分时不靠感觉:每条标准都写明"去查 F2 这个 sheet 的第几行",judge 照单验收 |
| "使每条评价标准都能追溯到具体文件" | 打分可复现、可审计:判 0 分要能指着说"这文件里没有这个数" |
#对 LLM Agent / 长轨迹 RL 的启发
这篇工作落在 wenjun 关心的几个坐标上:
1. 可验证奖励向"文档交付物"的延伸。 RLVR 的经典阵地是代码(跑测试)和数学(对答案)。Working Agent 的产出是 Excel 模型、投资报告——没有单元测试可跑。GraphForge 给出的答案是"证据锚定的 rubric judge":把验证问题转化为"声明-锚点-检查流程"的结构化规范。对于做 agent RL 的人,这相当于一个弱可验证环境的构造范式,比 pure LLM-as-judge 多了可追溯性和可审计性(judge 敏感性实验证明它真的在读文件)。但注意上限:judge 对细粒度内容错误的敏感度不足,说明这套 reward 信号仍偏粗——RL 想直接用还要再想 reward shaping。
2. 数据工程 > 算法创新。 GraphForge 没有新的训练目标、没有新的架构,全部训练组件(SFT 3 epoch + Muon 优化器 + 262k 序列打包;RFT best-of-4 选择)都是标准件。创新全在数据管线的结构化程度上:种子控制多样性、文件角色控制难度、证据图控制可验证性、一步修订控制可执行性、准入阈值控制质量。3,638 个任务最终只留下 2,169 条轨迹(59.6% 准入率)——高质量长轨迹数据天然是漏斗形的。
3. 与"超长轨迹直接 RL"的张力。 2,169 条轨迹、平均 162k token,SFT + 一次 RFT 就有 +65.7 Elo——这对在超长 agent 轨迹上做直接 RL 的可持续性是一个数据点级的正面证据:结构化合成的 SFT 数据目前性价比极高。GraphForge 的 RFT(在 SFT 模型自己的 rollout 上用 rubric 选择再训一轮)本质上是无梯度信号的 offline RL-lite,涨了但幅度小(+4 ~ +11),也符合"选择信号有用但不是全部"的预期。真正的 on-policy RL(GRPO 类)在这类环境上怎么搭 credit assignment,论文没碰,是明显的下一步。
4. "验证与执行分离"的接口设计值得抄。 锚点只给 judge 不给执行者,既避免泄漏解法又保证可验证——这个信息不对称设计对任何"构造可验证 agent 环境"的工作都直接可复用。
#局限与没解决的问题
论文自己列了三条:语料只有 2,169 条、未研究随数据预算的 scaling;管线和 judge 全靠 GLM-5.2,更强的教师能抬多高的天花板未知;只在 Qwen 家族两个底座上验证。我再补两条观察:GDPVal 的 220 题让 Elo 噪声很大(RFT 消融已经暴露);confuser 文件的干扰强度、judge 对细粒度数值错误的钝感,都意味着"可验证"目前是结构级而非内容级的。另外群消息宣传的 Atria-Preview/GLM-5.2 后训练在论文里没有对应实验,读推送时注意区分宣传口径与论文口径。
#相关阅读
- GDPVal(arXiv:2510.04374):本文主基准,OpenAI 的 44 职业 1320 任务专家 rubric 评测。
- EnvCraft(arXiv:2609.05576):模型生成文件 + 状态脚本验证,GraphForge 的主要对照。
- NexForge(arXiv:2607.14186):真实文件但无验证器,开放基线 Nex-N2-Mini-35B 的出处。
- Workspace-Bench(arXiv:2605.03596)、SpreadsheetBench 2(arXiv:2606.29955):另两个评测。
- OpenThoughts-Agent(arXiv:2606.24855):同期 agentic 数据配方,可对照阅读。