#OPSD 体检报告:给自己当老师的蒸馏,什么时候灵、什么时候崩
论文:Diagnosing On-Policy Self-Distillation for Reasoning Language Models(arXiv:2609.39118,北京大学,2026-09-30)
一句话:把 OPSD 放到 0.6B–8B、11 个模型、上百组控制变量下"体检",结论是——OPSD 的"老师信号"主要来自前缀分布差异,而不是特权语义;它只在很窄的兼容区间里涨点,出了这个区间就是无效变长、稳步退化或行为崩溃。OPSD 是一个敏感算法,不是可靠的通用后训练方法。
#1. 先用人话把 OPSD 讲清楚
#1.1 问题背景:RLVR 的痛点
现在训练推理模型的主流路线是 RLVR(可验证奖励的强化学习):模型做数学题,最后答案对了给奖励,错了不给,用 GRPO/DAPO 这类算法更新。它有两个痛点:
- 奖励太稀疏。一道题几百上千个 token 的推理过程,最后只拿到一个"对/错"信号。到底是哪一步走对了、哪一步走歪了?奖励不告诉你。这就是信用分配(credit assignment)问题。
- 太贵。每次更新都要采样一组回复、跑验证、算优势,算力和时间都烧得厉害。
#1.2 蒸馏路线怎么解决这个痛点
OPD(On-Policy Distillation):找一个更强的模型当老师。学生在题目上自己写(on-policy rollout),每写一个 token,老师就看一眼"到你这为止的草稿",给出它认为下一个 token 应该是什么分布。这样每个位置都有信号——密集监督,比"最后对不对"细得多。
OPSD(On-Policy Self-Distillation):把老师换掉——不用更强的外部模型,而是冻结一份学生自己的初始副本当老师,并且给这份老师看"特权信息":题目参考答案、解题过程等。直觉是:老师=自己+答案,能力肯定比裸做的学生强,那信号不就有了吗?而且不用外购更强的教师模型。
用个比喻:学生闭卷考试时,另一个"看过答案的平行自己"坐在旁边,逐字告诉你"下一个词我会怎么写"。听起来很美——密集、便宜、不需要外聘名师。
#1.3 但社区里报告的结果非常分裂
有人报告 OPSD 有提升,有人报告它崩掉:输出爆炸变长、复读、格式损坏(\boxed{} 都写不出来)、性能大幅下降。同一种方法,效果从"小涨"到"崩溃"都有。这篇论文就是来搞清楚:为什么?OPSD 的信号到底是什么?什么条件下它有用?训练时的什么征兆能提前预警?
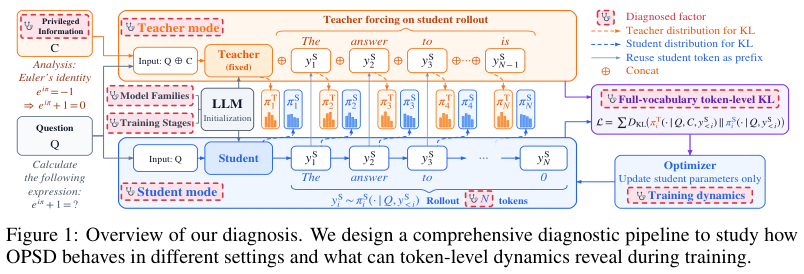
上图是论文的整个诊断流水线(论文 Figure 1):学生 rollout → 冻结的特权老师对同一条前缀打分 → 全词表 token 级 KL → 只更新学生 → 训练动态诊断。诊断的变量包括模型家族、训练阶段、初始化、老师上下文、rollout 长度等。
#2. 核心发现一:OPSD 的"老师信号"主要不是语义,是前缀分布
这是全文最反直觉、也最重要的结论。
#2.1 实验设计:换掉老师的"特权上下文"
作者做了一个非常干净的控制实验。学生永远只看到题目 Q;而老师看到的输入在几档之间切换:
- Full solution:题目 + 完整参考解法(标准 OPSD);
- Answer only:题目 + 最终答案;
- Unrelated solution:题目 + 另一道不相关题目的解法(来自 DAPO-Math-17k,去重);
- CoT + solution:题目 + 思维链 + 解法(信息更多、前缀更长,prompt 预算从 1024 提到 8192)。
如果 OPSD 的收益真来自"特权语义"(老师懂了答案,给出了更有道理的逐 token 指导),那应该是:Full solution > Answer only > Unrelated solution,且信息越多越好。
#2.2 实际结果:排序是非单调的,而且"无关解法"居然挺能打
五组模型、两种 rollout 长度下的宏观平均(论文 Table 3):
| 老师上下文 | Avg@8(256 cap) | Pass@8 | Avg@8(1024 cap) |
|---|---|---|---|
| Full solution | 50.5(+0.9) | 71.5(+1.0) | 48.6(−1.0) |
| Unrelated solution | 48.9(−0.7) | 69.7(−0.8) | 47.8(−1.8) |
| Answer only | 45.9(−3.7) | 65.7(−4.8) | 44.3(−5.3) |
三个要点:
- Unrelated solution 打败 Answer only。给老师塞一道毫不相关题的解法,效果竟然比给它正确答案更好。这说明起作用的不是"答案语义",而是老师前缀的整体分布形状——一个完整解法文本改变了老师的输出风格/长度/结构,而孤零零一个数字"答案是 0"做不到。
- CoT+solution 信息更多,效果反而更差或持平(Qwen3-1.7B 的 Avg@8 从 35.3 掉到 30.8;OLMo-3-7B-Think 从 58.8 到 58.6,没有提升)。更多信息 ≠ 更好的监督。
- 结论:特权信息应该被理解为"对老师条件分布的一次干预",而不是"知识的注入"。加上下文会拉大老师-学生的分布差异(前向 KL 变大),但"更强的信号"≠"更有用的信号"。
#2.3 推理模式错配实验:最釜底抽薪的一刀
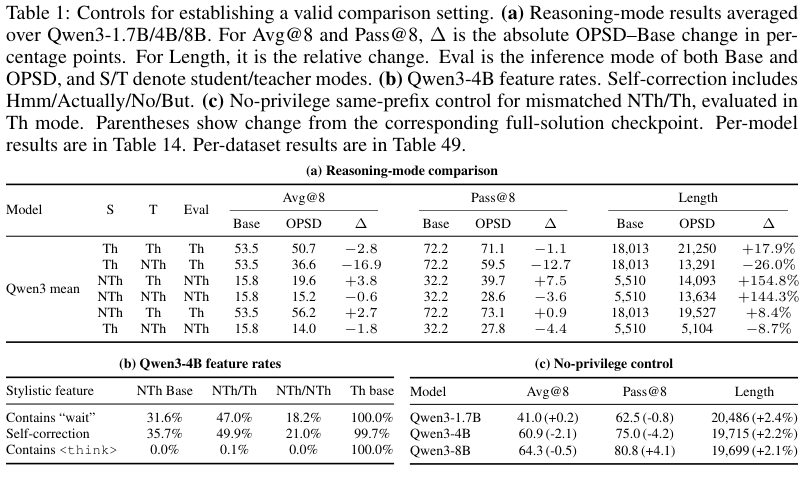
Qwen3 有 Think / NoThink 两种模式。作者做了学生/老师模式交叉实验(论文 Table 1a,Qwen3 平均):
| 学生 S | 老师 T | Avg@8 变化 | 长度变化 |
|---|---|---|---|
| Th | Th | −2.8 | +17.9% |
| Th | NTh | −16.9 | −26.0% |
| NTh | Th | +3.8 | +154.8% |
| NTh | NTh | −0.6 | +144.3% |
看 NoThink 学生 + Think 老师这一行:+3.8、Pass@8 +7.5。表面上 OPSD"涨点"了。但是——
- 检查输出特征发现,学生的回答里出现了大量 Think 风格的词("wait"、Hmm/Actually 自我纠正),也就是说学生学会了 Think 模式的说话方式;
- 更关键的是无特权同前缀对照(Table 1c):把老师的特权信息整个去掉、只保持前缀模式对齐,结果和完整特权版本几乎一样(55.4 vs 56.2)。
所以那点"涨点"其实是:把 base 模型本来就会的 Think 行为"解锁"出来了,不是真的提升了推理能力。之前社区报告的一些 OPSD 提升,可能只是模式迁移/行为恢复的假象。
(这一点与 Shrestha & Tessier 2026 的独立发现互相印证:OPSD 的表面改进可能是恢复 base 模型已有的推理行为,而非新增能力。)
#3. 核心发现二:涨点只存在于很窄的"兼容区间"
OPSD 的效果取决于一长串因素的联合作用:模型能力、rollout 长度、训练步数、老师上下文、初始化阶段。换掉任何一个,结论都可能翻转。
#3.1 模型能力:越强越不受益
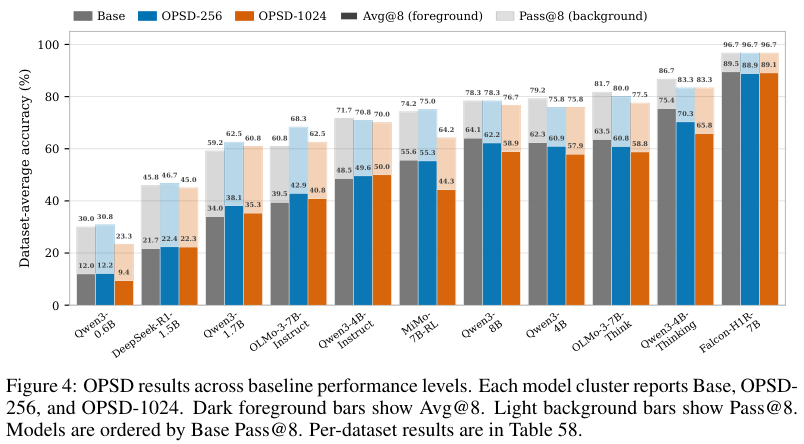
11 个模型,Base / OPSD-256 / OPSD-1024 三档对比(论文 Figure 4):
结论非常清晰:
- 只有一些低能力模型受益(如 Qwen3-0.6B、Qwen3-1.7B、OLMo-3-7B-Instruct 小涨);
- 大多数高能力模型退化(Qwen3-4B-Thinking −9.6,MiMo-7B-RL −11.3/−10.0 等);
- Instruct 模型普遍比 Reasoning 模型受害更轻——作者推测是 Instruct 模型的指令跟随能力更强,能把特权信息转成"有针对性的纠正",而不是全盘照抄老师的风格。
这个模式和 Kaur et al.(2026,就是"Rethinking OPSD for thinking models"那篇)的发现一致,但这里覆盖面更广。
#3.2 Rollout 长度:短比长好
训练时学生 rollout 上限从 128 一路扫到 6144 token(论文 Figure 3):
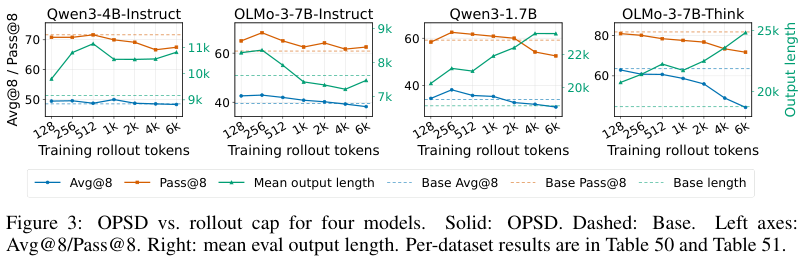
Instruct 模型上,性能随 rollout 变长单调下降;短的(128–512)和中等的与 base 持平甚至略好,最长的设置全面掉精度。同时输出长度普遍膨胀。
#3.3 训练步数:练得越久越差
把 Qwen3-1.7B 和 OLMo-3-7B-Think 训到 300 步、每 50 步评估一次(论文 Figure 2):整体趋势是继续训只会更差,中间偶尔小反弹。100 步的默认设置(还是 1e-6 的小学习率!)已经是接近最好的了。
#3.4 损失设计:换散度不是万能药
OPSD 原版用前向 KL(β=0)。作者消融了对称 JSD(β=0.5)和反向 KL(β=1)(论文 Table 5a):不同模型的最佳散度各不相同——Qwen3-1.7B 上前向 KL 最好,OLMo-3-7B-Instruct 上反向 KL 最好。换散度方向只是"重新洗牌结果分布",不是可靠的修复手段。词表截断、teacher-favored 位置选择、熵掩码这些局部改造,同样没有普适收益。
#3.5 训练阶段:换一个阶段,崩法就换一种
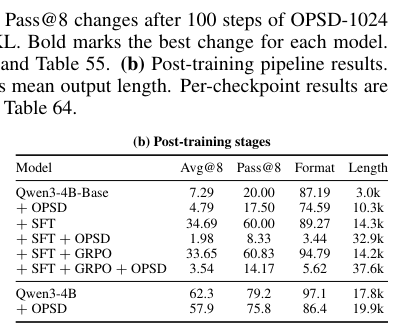
这是论文里最"惨烈"的一张表(论文 Table 5b,Qwen3-4B 系):
| 阶段 | Avg@8 | Pass@8 | 格式率 | 长度 |
|---|---|---|---|---|
| Qwen3-4B-Base | 7.29 | 20.00 | 87.19% | 3.0k |
| + OPSD | 4.79 | 17.50 | 74.59% | 10.3k |
| + SFT | 34.69 | 60.00 | 89.27% | 14.3k |
| + SFT + OPSD | 1.98 | 8.33 | 3.44% | 32.9k |
| + SFT + GRPO | 33.65 | 60.83 | 94.79% | 14.2k |
| + SFT + GRPO + OPSD | 3.54 | 14.17 | 5.62% | 37.6k |
| 官方 Qwen3-4B | 62.3 | 79.2 | 97.1% | 17.8k |
| 官方 + OPSD | 57.9 | 75.8 | 86.4% | 19.9k |
看 + SFT + OPSD 那一行:SFT 把模型从 7 分拉到 34.7 分,紧接着一段 OPSD 直接打到 1.98 分,格式率从 89% 崩到 3%,输出膨胀到 32.9k token——这是教科书级的行为崩溃。SFT+GRPO 之后再上 OPSD,一样崩。而在官方发布版 Qwen3-4B 上做模式匹配的 OPSD,则是"温和退化"(−4.4)。
同一算法,不同起点,三种崩法:低能力起点→无效变长;训练管线中间→崩溃;成熟模型→稳定退化。这解释了为什么社区报告互相矛盾——大家用的不是同一种"OPSD",虽然代码可能一模一样。
#3.6 和 GRPO 正面比:便宜 170 倍,但优势不保真
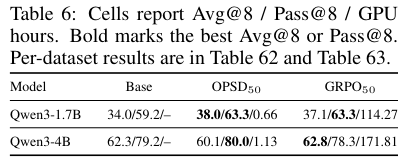
同样 50 步、同一批 OpenMathReasoning 题目(论文 Table 6):
| 模型 | Base | OPSD-50 | GRPO-50 |
|---|---|---|---|
| Qwen3-1.7B | 34.0/59.2 | 38.0/63.3,0.66 GPU 时 | 37.1/63.3,114.27 GPU 时 |
| Qwen3-4B | 62.3/79.2 | 60.1/80.0,1.13 GPU 时 | 62.8/78.3,171.81 GPU 时 |
1.7B 上 OPSD 用 0.66 GPU 时打平/超过 GRPO 的 114 GPU 时——计算效率优势确实惊人(百倍量级)。但到 4B,OPSD 的精度优势就没了(62.8 vs 60.1,GRPO 反超)。精度优势不随规模保持,计算优势保持。所以论文的定位建议是:OPSD 是 RLVR 的补充(低算力场景的密集信号来源),不是替代品。
#4. 核心发现三:token 级解剖——信号不稳、不可预测、集中在前部
前面的实验是"结果层面"的诊断,这一部分是"信号层面"的解剖:冻结模型,对 4096 条 rollout 逐 token 计算老师-学生的前向 KL。
#4.1 模式错配会放大初始信号(但没有语义)
论文 Table 7(Qwen3-1.7B 网格):错配组合(Th/NTh 0.468、NTh/Th 0.193)的前向 KL 和高散度位置占比远高于匹配组合(~0.10–0.14),但 top-1 一致率几乎不变(87–94%)。也就是说差异发生在 argmax 以下的分布质量上,且错配把采样位置从"鼓励"推向"抑制"(Enc./Disc. 比例翻转)。这再次支持"分布干预"而非"语义传递"的解释。
#4.2 不同特权上下文的信号在 PCA 上按"分布形状"聚类
对 10 个模型、7 种上下文条件做 token 级信号的 PCA(论文 Figure 5a):同一种上下文类型(不管来自哪个数据集)聚在一起,从 Answer only → Full solution → CoT+Solution 单调移动;Unrelated solution 也产生明显位移。换数据集几乎不动,换上下文类型大幅移动——信号反映的是老师的完整前缀,不是任务内容。
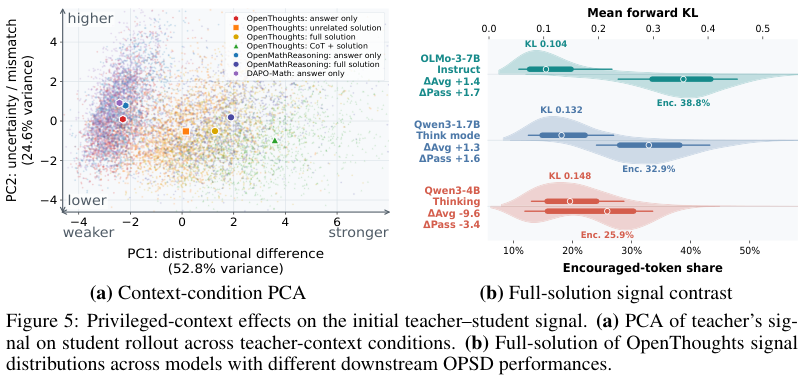
右半边(Figure 5b)还有一个扎心的对比:两个 OPSD 后涨点的设置和一个跌点的设置,它们的信号分布大量重叠——平均前向 KL 和鼓励 token 占比都不能预测下游性能。
#4.3 信号集中在前 128 个 token,后面又弱又噪
按位置窗口统计前向 KL(论文 Table 11):[0,128) 窗口均值 0.287、信噪比 0.248;到 [4k,6k) 窗口只剩 0.048/0.103——后段信号强度和信噪比同步塌陷。对应到训练上:同样 256 个监督位置的预算,First-256(只监督前 256 个位置)比 Uni-256 和 Final-256 都好(Table 2)。
这呼应了 Zhou et al.(2605.27028,"Less is more: early stopping rollout")的发现:一旦 rollout 走上岔路,后半程的老师信号既弱又可能是毒药。实操含义:OPSD 根本不需要对整条轨迹算 loss,只监督前段即可,又快又好。
#4.4 训练动态:能预警崩溃,但预测不了最终性能
追踪训练中的熵、前向 KL、clipped loss、梯度范数(论文 Figure 6):
- 最清晰的崩溃签名:学生熵和梯度范数同步上升(SFT+GRPO 初始化的 actor 就是这个模式),而健康运行的 Qwen3-4B 两者有界或下降;
- Instruct 检查点普遍前向 KL 更低、clipped loss 负得少,没有崩溃签名——和它下游表现更稳一致;
- 但没有任何单条曲线能可靠预测最终性能;前 10 步的 KL 也预测不了涨还是跌(Table 10:KL 上升/下降与 ΔAvg 正负没有对应关系)。
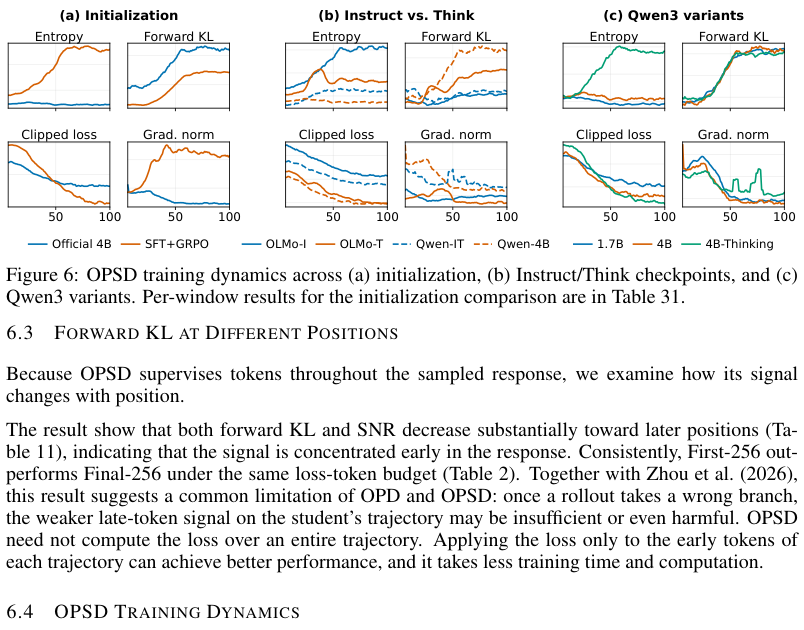
实操含义:把"熵+梯度范数同涨"当作在线熔断信号,训练中就能拦住崩溃;但别指望靠 loss 曲线预测涨点。
#5. 我的解读:这篇论文到底证明了什么
把三组发现拼起来,可以讲一个连贯的故事:
- OPSD 的"老师"没有真的在教推理。 特权上下文对老师条件分布的作用,更像"催眠提示"(改变风格、长度、结构),而不是"知识注入"(给出更正确的下一步)。无关解法、模式迁移、无特权对照三组实验共同钉死了这一点。
- 它偶尔有效,是因为偶尔踩中了"兼容区间"。 学生和老师的分布差异要"形状合适、幅度合适":低能力模型 + 短 rollout + 匹配的模式 + 恰当的上下文长度。这是一个多变量联合的小窗口,不是普适性质。
- 它的失败模式是系统性的,和分布差异的失控放大有关:无效变长(差异变成"多写点"的压力)、稳定退化(慢慢滑向老师前缀的表面统计)、行为崩溃(训练动态发散)。熵+梯度同涨是崩溃的前兆。
- 它真正的卖点是性价比,不是能力上限。百倍于 GRPO 的计算效率,对小模型、低算力、特定阶段,是有真实价值的。作为 RLVR 的补充工具合理,作为"替代 RLVR"的叙事不成立。
一个更深的理论视角(我的延伸,非论文原文):OPSD 本质上是在用一个分布干预器当老师,而 OPD 用能力差距当老师。前者传递的是"如何在这个上下文里说话",后者才可能传递"如何解这道题"。当学生和老师的能力差距趋近于零(OPSD 的定义!),可传递的东西只剩下分布本身——这就是为什么涨点窗口窄、且多为行为迁移。
#6. 方法论亮点:什么叫"诊断型论文"
这篇论文值得学的不是结论,是实验设计:
- 先建立有效对照,再做实验:第 5.1 节花整整一节证明"模式错配会污染归因",把后续所有实验钉在匹配模式上。很多 OPSD 文献的分歧可能就出在这个对照没做。
- 无特权同前缀对照:想知道"特权信息"的贡献?把特权信息删掉、其余全部不变再跑一遍。这个对照的设计干净得漂亮。
- Unrelated solution 这个条件:用一个"语义无关但分布相同"的对照,一刀切开"语义"和"分布"两个混杂变量。这是整篇论文最聪明的一个实验。
- 冻结信号的 token 级解剖 + 训练动态监测:把"为什么崩"从猜测变成了可测量的量(KL 的位置分布、熵+梯度的联合上升)。
- 同一因素网格扫描(模型×rollout×步数×上下文×阶段×散度),每个实验只动一个变量。
#7. 局限
- 模型最大 8B,更长上下文、更大模型、非数学任务(代码、agent 轨迹)未覆盖,作者自己也承认泛化性待验;
- 100 步、1e-6 学习率的"短训"设定,一些结论(如"训练越久越差")在更长程训练下是否成立待确认;
- 对"为什么 Instruct 模型更皮实"的解释(指令跟随→针对性纠正)还是推测性归因,缺直接的机制验证;
- 老师前缀对信号的影响被归因为"分布形状",但分布形状里具体哪些成分(长度?句式?词频?)起作用,还没有拆到底。
#8. 对 wenjun 研究方向的启发
几条和你的主线(LLM Agent、model-based RL、潜空间推理、长轨迹 RL)直接相关的想法:
- "密集信号"的来源要过"语义 vs 分布"这一关。 这篇论文给的方法论(无关上下文对照、无特权同前缀对照)可以直接搬去检验其他密集信号源:process reward model、critic 模型、world model 给的 next-state 预测损失。如果 PRM 的信号也主要是分布干预而非语义判断,那很多"密集监督有效"的报告可能都需要重新归因。
- OPSD 和 model-based RL 的结构同构性。 OPSD 的老师 = f(Q, C) 的冻结副本,很接近"world model / 想象中的专家"的角色。这篇论文的教训翻译到 model-based RL:想象轨迹上的监督信号,同样会被"想象分布与现实分布的失配"主导,而非价值语义。Dreamer 式的 LLM agent 里,怎么控制这个失配(而不是最大化 teacher-student 差异),是一个可以做的机制性课题。
- 长轨迹上的信号衰减是普遍规律。 前向 KL 和 SNR 随位置指数衰减、岔路之后信号失效——这对超长 agent 轨迹 RL 意味着:无论是蒸馏信号还是 PMM 信号,都天然偏向前段。和早停 rollout(Zhou et al. 2026)互为印证,也暗示潜空间推理的一个潜在优势:压缩表示可能天然规避 token 级前缀漂移问题。
- 崩溃预警(熵+梯度同涨)是免费的在线诊断。 任何 on-policy 训练(包括 agent RL)都值得挂上这个监控,成本几乎为零,但能在评估之前拦住行为崩溃。
- 算力叙事: OPSD 0.66 GPU 时 vs GRPO 114 GPU 时——对于"在长轨迹上直接 RL 是否可持续"这个问题,这篇论文提供了一个新的数据点:密集自监督信号的性价比极高但天花板存疑,而 RLVR 贵但上限更稳。混合方案(OPSD 做冷启动/补充,RLVR 做锚定)是论文和一系列后续工作(SRPO、β-OPSD、RLSD)共同指向的方向。
#9. 一句话总结
OPSD 不是一个"老师",它是一面"分布镜子":你给它什么前缀,它就照出什么分布。想让它涨点,别研究给它塞多少知识,先研究学生和镜子的分布怎么才能对得上——而对得上的窗口,比你想象的窄得多。