#用采样"翻译"专家数据:SFT 其实比你想的强得多 —— Projection Sampling 详解
论文:Finetuning with Sampling: SFT Learns Better Than You Think(Aayush Karan, Sitan Chen, Yilun Du,Harvard,2026-10)
#一句话 thesis
SFT 学不好的锅,不在 SFT 这个学习算法,而在喂给它的数据太 off-policy。与其改目标函数,不如在训练前用 MCMC 采样把专家数据"改写"成 base model 自己会说的话——改写完再 SFT,泛化和保留旧能力都超过 on-policy RL。
这篇论文直接挑战了当前 posttraining 领域最有共识的一条"slogan":RL 泛化好、SFT 记忆+遗忘。它给出的答案是:SFT 的弱不是本质属性,是数据分布问题。
#1. 它想解决什么问题
#1.1 背景共识:RL vs SFT
近两年的大量工作(Chu et al. 2025 "SFT memorizes, RL generalizes"、Shenfeld et al. 2025 "RL's Razor"、Chen et al. 2025)指向同一组结论:
- RL 泛化好:因为 on-policy,模型自己采样、自己更新,学到的分布离 base model 不远,旧能力天然保留;
- SFT 泛化差、灾难性遗忘:因为 off-policy,硬灌专家轨迹,梯度大且不稳,模型被拽到离 base model 很远的地方(Xiong et al. 2025 甚至给出了数学解释,Shenfeld 用实证表明遗忘程度与 finetuned model 对 base model 的 KL 散度正相关)。
#1.2 但 on-policy 也有致命短板
RL 靠模型自己反复采样找到成功轨迹。如果模型连一个正确 rollout 都采不出来,奖励方差为零,学习信号就是零。Qu et al. 2026 (POPE) 在实践中观察到:存在一大块"太难"的训练样本,在 RL 里被整块丢弃——恰好是"引入新能力"最需要的样本(模型本来就不会,才需要学)。
而这里恰是 SFT 的主场:SFT 直接吃 off-policy 专家轨迹,不需要模型先会做,也不需要可显式定义的 reward。
#1.3 论文的核心提问
两个范式各拿了一半的好处:
| RL / on-policy | SFT / off-policy | |
|---|---|---|
| 数据来源 | 模型自己采样 | 专家轨迹(特权信息) |
| 泛化 & 防遗忘 | ✅ 好 | ❌ 差 |
| 冷启动新能力(模型不会的题) | ❌ 零信号直接放弃 | ✅ 有监督信号 |
能不能同时拿到两半? 之前的工作走的是"改学习目标"路线(重要性加权 SFT、加 KL 项的 anchored SFT、GRPO 里塞专家 in-context 的 UFT/POPE)。这篇论文反着来:学习算法(SFT)原封不动,改数据分布。
直觉类比:与其给一个消化不好的人换药(改 loss),不如把食物预先咀嚼打碎成他好吸收的形态(改数据)。数据是为学习者定制的,而不是让学习者去迁就数据。
#2. 方法:Projection Sampling
#2.1 形式化:目标是"信息投影"
给定 base model 分布 和专家轨迹集合 。定义等价类 :与专家轨迹"语义等价"的所有轨迹(数学题=任何能推出正确答案且用到专家信息的解法;事实类=LLM 判分器认为事实内容一致的回答)。
要找的数据分布是 在"只输出等价轨迹"这个约束集合上的信息投影(Csiszár 1995):
命题 1 给出闭式解: 就是 base model 限制在等价轨迹上的条件分布——"模型自己说的话里,所有说得对的那些"。这是既保住专家信息、又最贴近 base model 的理想数据分布。
人话:最理想的训练数据不是专家写的解答,而是"假如 base model 自己会这道题,它会怎么写"。专家数据的价值只是告诉你答案和关键信息,表述方式应该换成模型自己的。
#2.2 怎么采样:Metropolis-Hastings
直接从 采样做不到(等于要求模型本来就会做)。但如果模型连一个正确样本都采不出,就退化为普通 rejection sampling = 最低配 on-policy RL,回到冷启动问题。
论文的解法:用专家轨迹当起点,跑 MCMC,逐步演化。用 Metropolis-Hastings:从专家轨迹 出发,用"信息保持"的 proposal (只提议仍在 内的候选)变异,按接受率
决定是否接受。核心性质(命题 3):每一步 MCMC 都单调减小数据分布与 base model 的 KL 距离——数据被逐步"搬"向 on-policy,且全程不丢正确性。
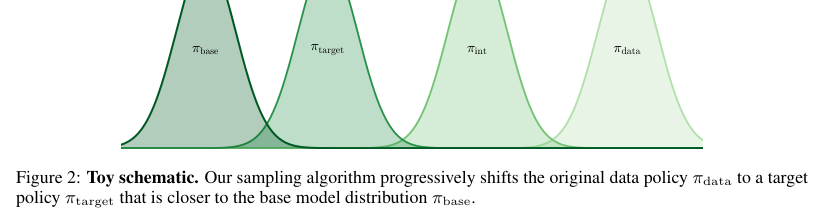
这就是上图的意思:(专家)经过采样链逐步移向 (贴近 )。采样步数是一个可以花钱买的轴:MCMC 跑得越多,数据越 on-policy。
#2.3 工程实现:块状 MH + in-context 改写
直接对全长序列做 MH 需要反复整段重新生成,且高维空间混合极慢。论文沿用 Karan & Du 2025("Reasoning with Sampling")的技巧:
- 分块:把长度 的序列按块长 (论文取 32)切成若干段,先采样第一块的分布,再以此为初始化采样下一块,逐块推进;
- Proposal 是"看着专家答案续写自己":随机截断当前候选到位置 ,然后把「题目 + 完整专家解 + 部分草稿」塞进 prompt,让 base model 以自己的口吻续写完,并要求与专家解逻辑一致、答案正确。预训练模型强大的 in-context 指令跟随能力保证了 proposal 基本落在等价类 内;
- 每块内跑 步 MH 接受/拒绝(接受率用 base model 的序列似然 + proposal 似然之比计算)。
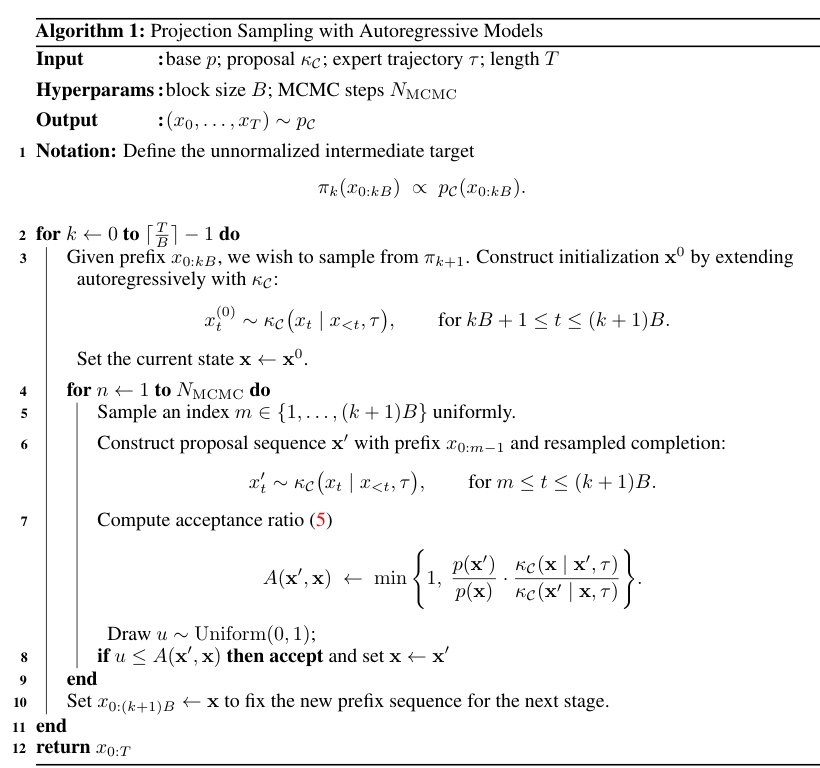
一个重要的成本性质:与 Karan & Du 2025 在推理时反复做 MCMC 不同,projection sampling 是训练前一次性成本(对数据集跑一遍就完),不进入推理路径。平均 token 开销约为 。
#2.4 和已有路线的本质区别
| 路线 | 代表 | 改什么 |
|---|---|---|
| 改目标函数 | Wu et al.(重要性加权 SFT)、Zhu et al.(+KL 项) | 让 SFT loss 去迁就 off-policy 数据 |
| RL 里借专家 | UFT、POPE | 让 RL rollout 时看专家 in-context |
| 自蒸馏 | OPSD | 构造"看了特权信息的 teacher",再 KL 蒸馏 |
| 本文 | Projection Sampling | SFT 一字不改,把数据改造成 on-policy 等价物 |
#3. 实验:SFT 打赢了谁
任务三个,都是"base model 本来不擅长"的领域:
- Chemistry:SciKnowEval L-3 子集(配平方程、摩尔质量等),Qwen2.5-7B-Instruct / Olmo-3-7B-Instruct,专家轨迹由 GPT-5 生成;
- Math:MATH 数据集 Level 3-5(最难档),Qwen2.5-3B,用数据集自带专家解;
- Medical:HuatuoGPT-o1 SFT 数据(约 2 万题),Qwen2.5-7B-Instruct,开放式回答用 GPT-5-mini 判分。
基线包括:vanilla SFT、Rewrite SFT(只用 proposal prompt 做一次零阶改写,即"0 步 MCMC")、OPSD(on-policy 自蒸馏,当前持续学习的强基线)、GRPO / UFT(math 上加的 RL 基线)。
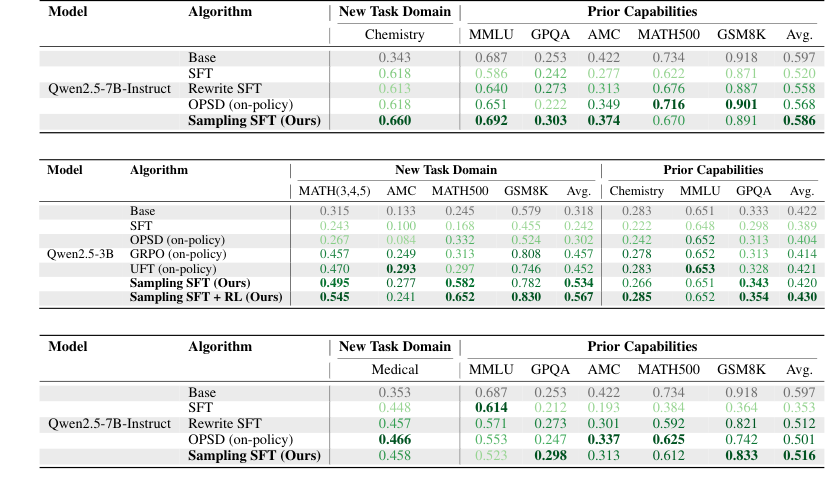
几个关键数字(相对 base model):
| 任务 | 指标 | Sampling SFT | 对比 |
|---|---|---|---|
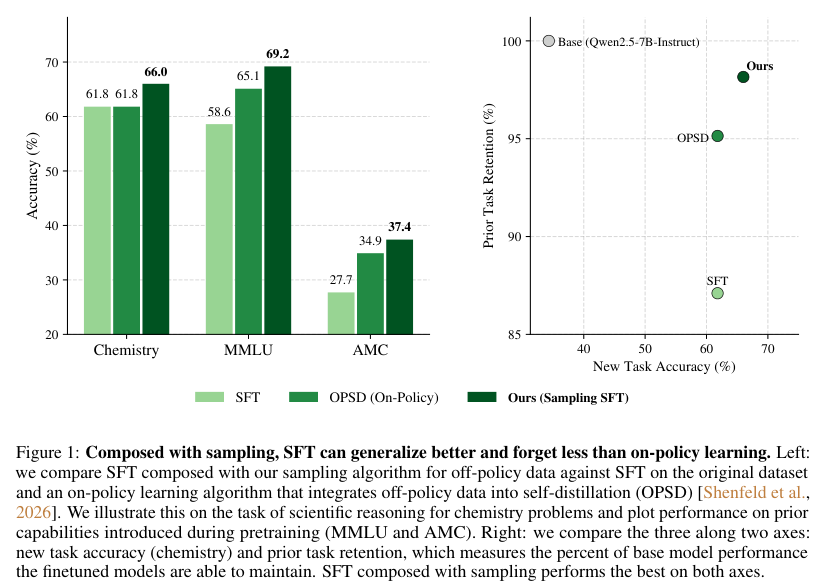
| Chemistry | 新任务 | +31.7%(0.660) | 比 OPSD 多 +4.2% |
| Chemistry | 旧能力均值 | -1.10% | 遗忘最少,MMLU 零损失 |
| Math (3B) | MATH(3,4,5) | +18.0%(0.495) | 超过 GRPO 的 +14.2% |
| Math (3B) | MATH500 (OOD) | +33.7%(0.582) | 超次优基线 +26.9% |
| Math (3B) | Sampling SFT + GRPO | +40.7% MATH500 | 全表最强 |
| Medical | 旧能力均值 | 损失仅 -8.1% | vanilla SFT 损失 -24.4% |
特别值得注意的两个消融证据:
- 一次改写不够:Rewrite SFT(只做一次零阶改写)明显弱于完整 MCMC 过程——说明"逐步向 on-policy 演化"的迭代本身是关键,不只是换个口吻;
- 必须 per-model 定制:用为 Olmo boost 的数据去训 Qwen,结果崩掉、低于所有基线。数据必须是对这个 base model on-policy 的,不能通用。
#3.1 数据真的变 on-policy 了吗
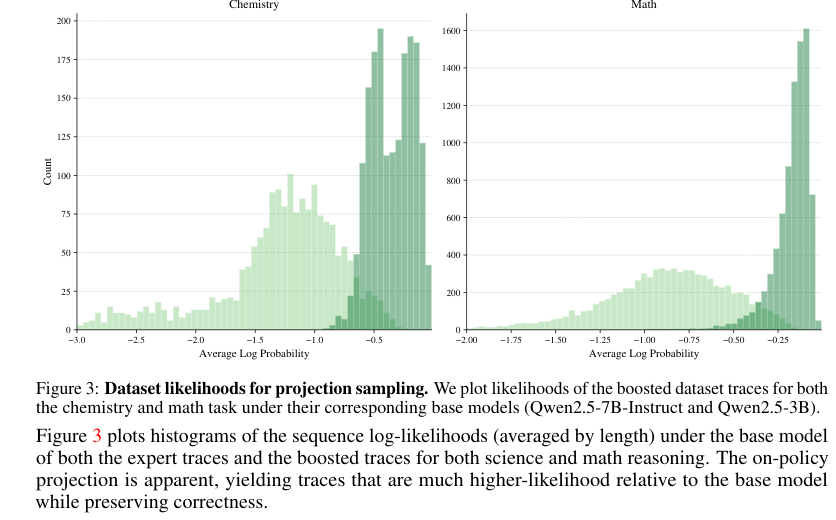
对训练数据在 base model 下算序列对数似然:boosted 轨迹的似然直方图整体大幅右移(math 上从约 0-1.5 提升到 1-2 nats/level),且保持正确性。"改写"是可度量的,不只是感觉。
#3.2 是学到新能力,还是只是 sharpening?
一个尖锐的问题:把数据推向模型分布内,会不会只是把 base model 已有的能力"锐化"(提高采样命中正确答案的概率),而非教会新东西?
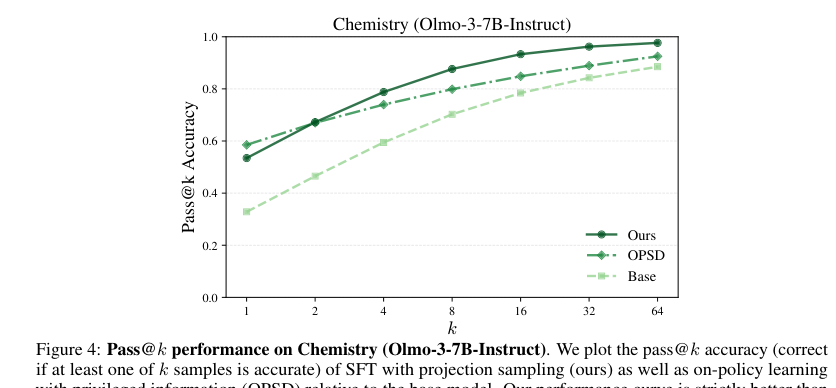
如果只是 sharpening,pass@k 曲线会随 增大收敛回 base model。实际上曲线严格高于 base 与 OPSD,到 差距依然巨大。更细的证据:base model pass@k 恒为 0 的"绝对做不出"的题,finetune 后 pass rate 升到 53.1%~67.2%——这是分布层面之外的新能力。
#3.3 采样算力是一个可扩展的轴
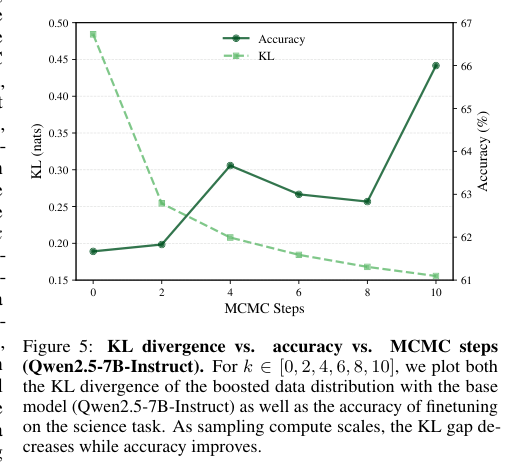
把 MCMC 步数从 0 扫到 10:数据分布的 KL 单调降、下游精度单调升。这给了 posttraining 一个新的 scaling 维度——训练前的数据采样算力,与训练算力、推理算力并列。
#4. 局限与没解决的问题
诚实地列几条:
- 等价类 依赖判分器/LLM grader:数学有 verifier,医疗靠 GPT-5-mini 判分。开放式领域里 的定义质量直接决定上限,"信息保持"在不可验证领域仍是个软假设;
- 一次性成本不小:,对超大数据集(预训练/持续预训练规模)是否可行未讨论,论文只在中型 SFT 数据(2 千~2 万样本)上验证;
- base model 弱到连 proposal 都给不出正确续写时会退化:in-context 跟随能力是 proposal 质量的前提,对极小模型或极难任务这一前提可能不成立;
- 任务粒度还是"单任务持续学习":连续学多个新任务、任务间干扰、以及与 full posttraining 流水线(RLHF 偏好数据)的衔接,论文只给了展望没给实验;
- 理论上 MH 收敛需要不可约+非周期,LLM 的高维离散空间实际只跑 10 步,远未收敛到 ——但实验说明"部分 on-policy 化"已经够用,这本身也是个有意思的观察。
#5. 为什么这件事重要:采样作为 posttraining 的通用原语
论文最后一段的野心值得单独说:把"采样"提升为 model-native 的数据算子(model-native operator that shapes data for learnability)。三个可推广的方向:
- SFT(本文主体):off-policy 专家数据 → on-policy 等价物;
- 蒸馏:MCMC 直接从初始蒸馏轨迹诱导出一个 KL 上更贴近 student 的 teacher 分布,更新更稳;
- RL 冷启动:在模型采不出成功轨迹的难题上,条件于专家信息模拟"on-policy rollout",制造学习信号——正对着 POPE 指出的"难题被 RL 丢弃"的痛点。
#6. 对我们研究方向的启发
(以下是我的引申,非论文内容)
- "SFT vs RL"之争可以重新框定为"数据 off-policy 程度"的谱系问题。既然 KL(数据 ‖ base) 单调可控、且与下游泛化/遗忘强相关,它就是一个可操作的中间变量——比"SFT/RL"这个二分法细得多。后续工作可以系统量化:多大规模下、多少 KL 程度是"最优甜点"。
- 与长轨迹 Agent RL 的直接接口:Agent 任务几乎全是"模型采不出完整成功轨迹"的冷启动场景。projection sampling 提供了一条不依赖 reward、不依赖模型先验成功率的替代路径:拿专家 agent 轨迹做 MCMC 演化,逐块变成 base model 的"自然行为"。对环境交互昂贵、奖励稀疏的设定尤其值得试。
- Model-based 视角:MCMC 步数 = 花 inference 算力买数据质量,本质上是用 base model 自身的分布知识去"重参数化"训练数据。这和 latent-space reasoning、inference-time scaling 是同一个哲学:模型分布本身就是可以被显式计算和操纵的对象,而不只是采样黑盒。
- 对持续预训练:数据单次改写成本高的问题,或许可以和"只 boost 高价值/高难度样本"结合——POPE 式的难度分层 + 投影采样,可能是一个高性价比的组合。
#参考
- 论文:arXiv:2610.02140(附 Website / Code 链接,见 arXiv 页)
- 直接相关工作:Karan & Du, Reasoning with Sampling(arXiv:2510.14901,推理时 MCMC 锐化的前作);Shenfeld et al., OPSD / Self-Distillation Enables Continual Learning(arXiv:2601.19897);Qu et al., POPE(arXiv:2601.18779);Chu et al., SFT Memorizes, RL Generalizes(arXiv:2501.17161)