#TEV:用"先造世界再出题"造出第一份长时程 Agent 训练集,把稀疏奖励变成密集进度奖励
原论文:TEV: Scaling Long-Horizon Agentic Environments with Dense Progress Rewards(arXiv:2610.18868,Adobe Research & UCLA,2026-10)。项目主页:https://tev-agent.github.io
#一句话讲清楚这篇论文
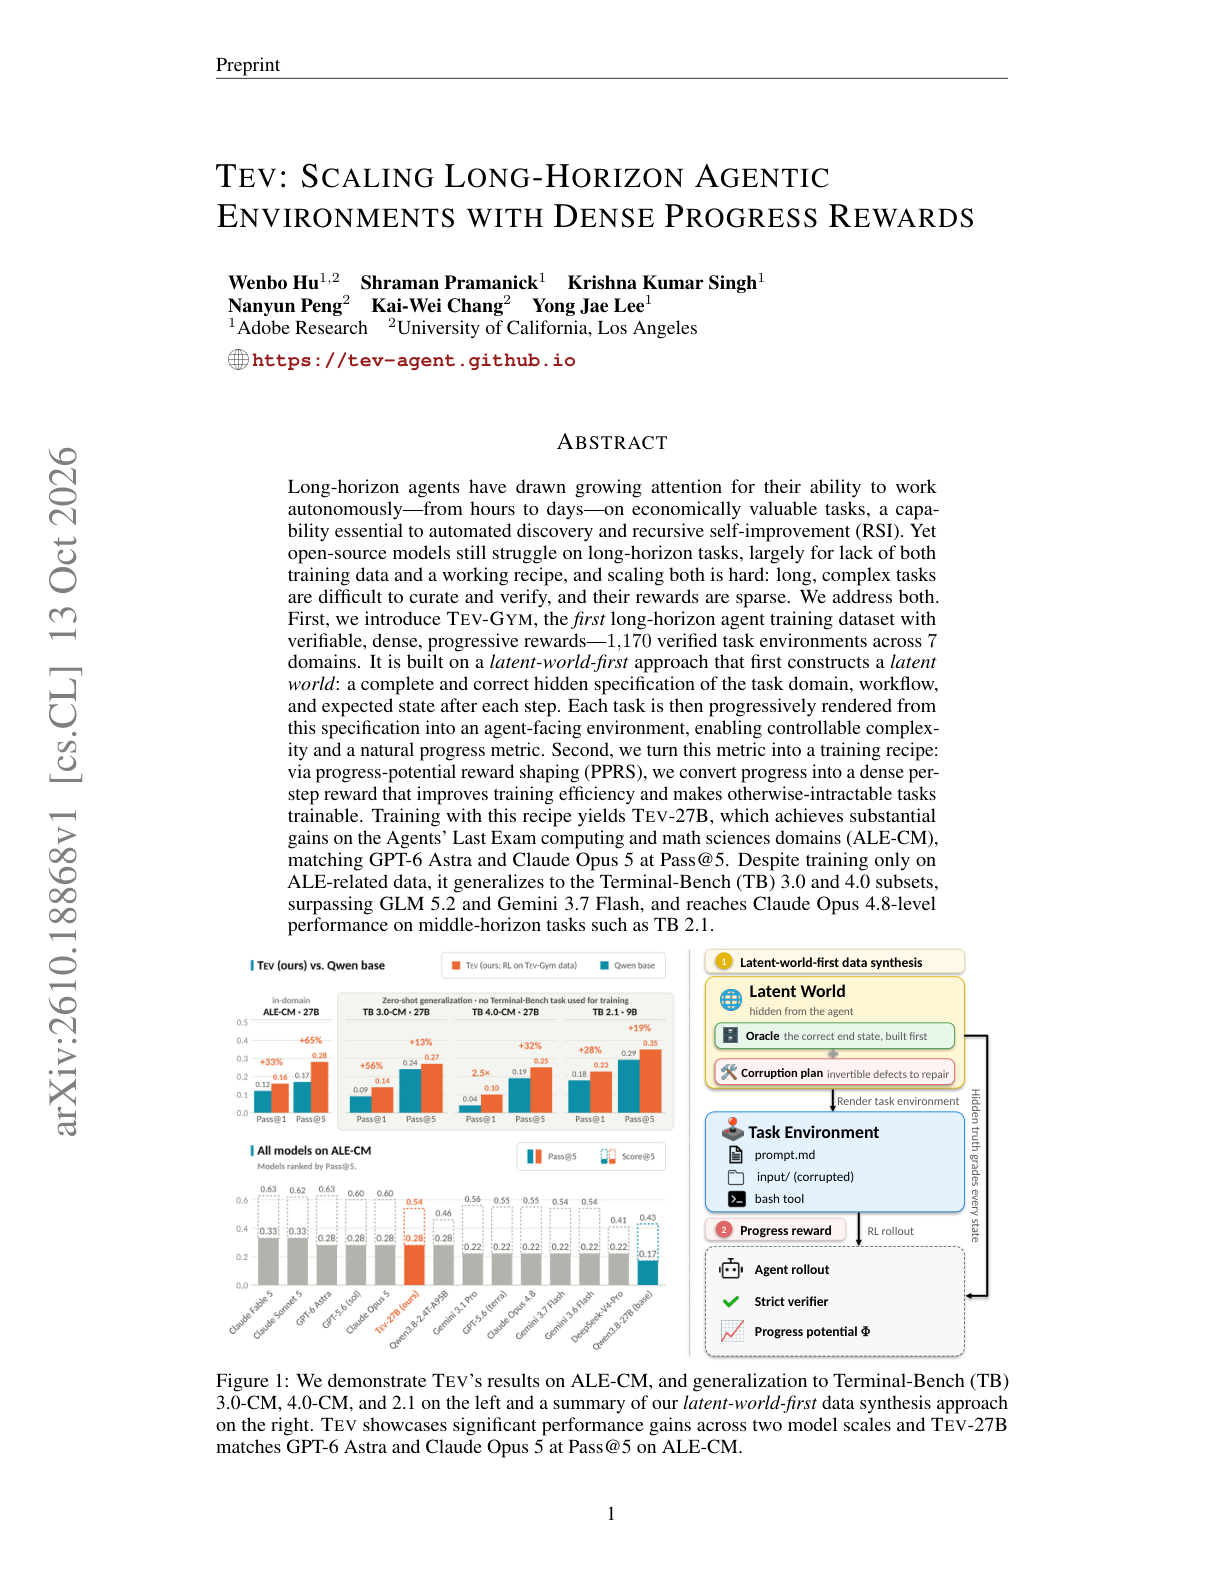
先把一个"正确的世界"造出来,再把这个世界渲染成题目丢给 agent 去修——因为答案在出题时就已算好,所以每一步的"进度"都可以被精确打分,这个进度分数再把稀疏到几乎没法训的终端奖励变成每一步都有信号的密集奖励。 用这套方法训出来的 27B 开源模型,在长时程基准 ALE-CM 的 Pass@5 上追平了 GPT-6 Astra 和 Claude Opus 5。
#它想解决什么问题
长时程 agent(能自主干几小时到几天的活)是现在大家都想要的的能力,但开源模型在这上面很弱,原因卡在两件事上,而且这两件事互相咬死:
1. 没有长时程训练数据。 现有的 agent 训练语料(SWE-Smith、TMAX、Endless Terminals、CLI-Gym、SETA、Terminal-Universe)虽然有几万条环境,但每条都只是"一个 PR 大小的修复"或"一次短终端会话",平均 agent 干活时间只有 0.5–2 分钟。真正的长时程任务只存在于人写的小规模评测集(几十到几百条,每条要专家几周时间),而且只用于评测、不用于训练。一句话总结现状:训练语料量大但时程短;长时程任务存在但只当考题。
2. 长时程任务的奖励稀疏到没法训。 GRPO 这类组相对 RL 里,同一任务采 G 条 rollout,用组内归一化算 advantage。如果用"最终通过/不通过"的二值终端奖励,那么全组都失败时,组内奖励全相同,advantage 全为 0,这 G 条 rollout 一点梯度都不贡献。如果模型解出该任务的概率是 p,浪费掉的小组比例是 (1−p)^G:p=0.05、G=8 时 66% 的组白跑;p=0.01 时 92% 白跑。而长时程任务恰恰是未训练开源模型 p≈0.03(论文实测)的地方——最需要信号的时候信号最少。中等时程的 pipeline 可以把这些废组直接丢掉(那里废组很少),长时程下丢掉就等于丢掉大半个 batch。
TEV 对这两个问题各给了一个解法:隐世界优先的数据合成(造出可验证、可控难度、自带进度信号的长时程环境)和进度势能奖励塑形 PPRS(把进度变成密集奖励修好 GRPO 饥饿)。
#核心思想一:隐世界优先(latent-world-first)合成
#人话版直觉
传统出题方式是"让 LLM 先写题目,再配套输入和检查器"——题目、输入、验证器是分别生成的,各自看着都合理,但可能描述的根本不是同一个问题(论文称为 artifact drift)。而且没有一个"标准答案",验证器本身可能就是错的。
TEV 反过来做,像出"修房子"的题:
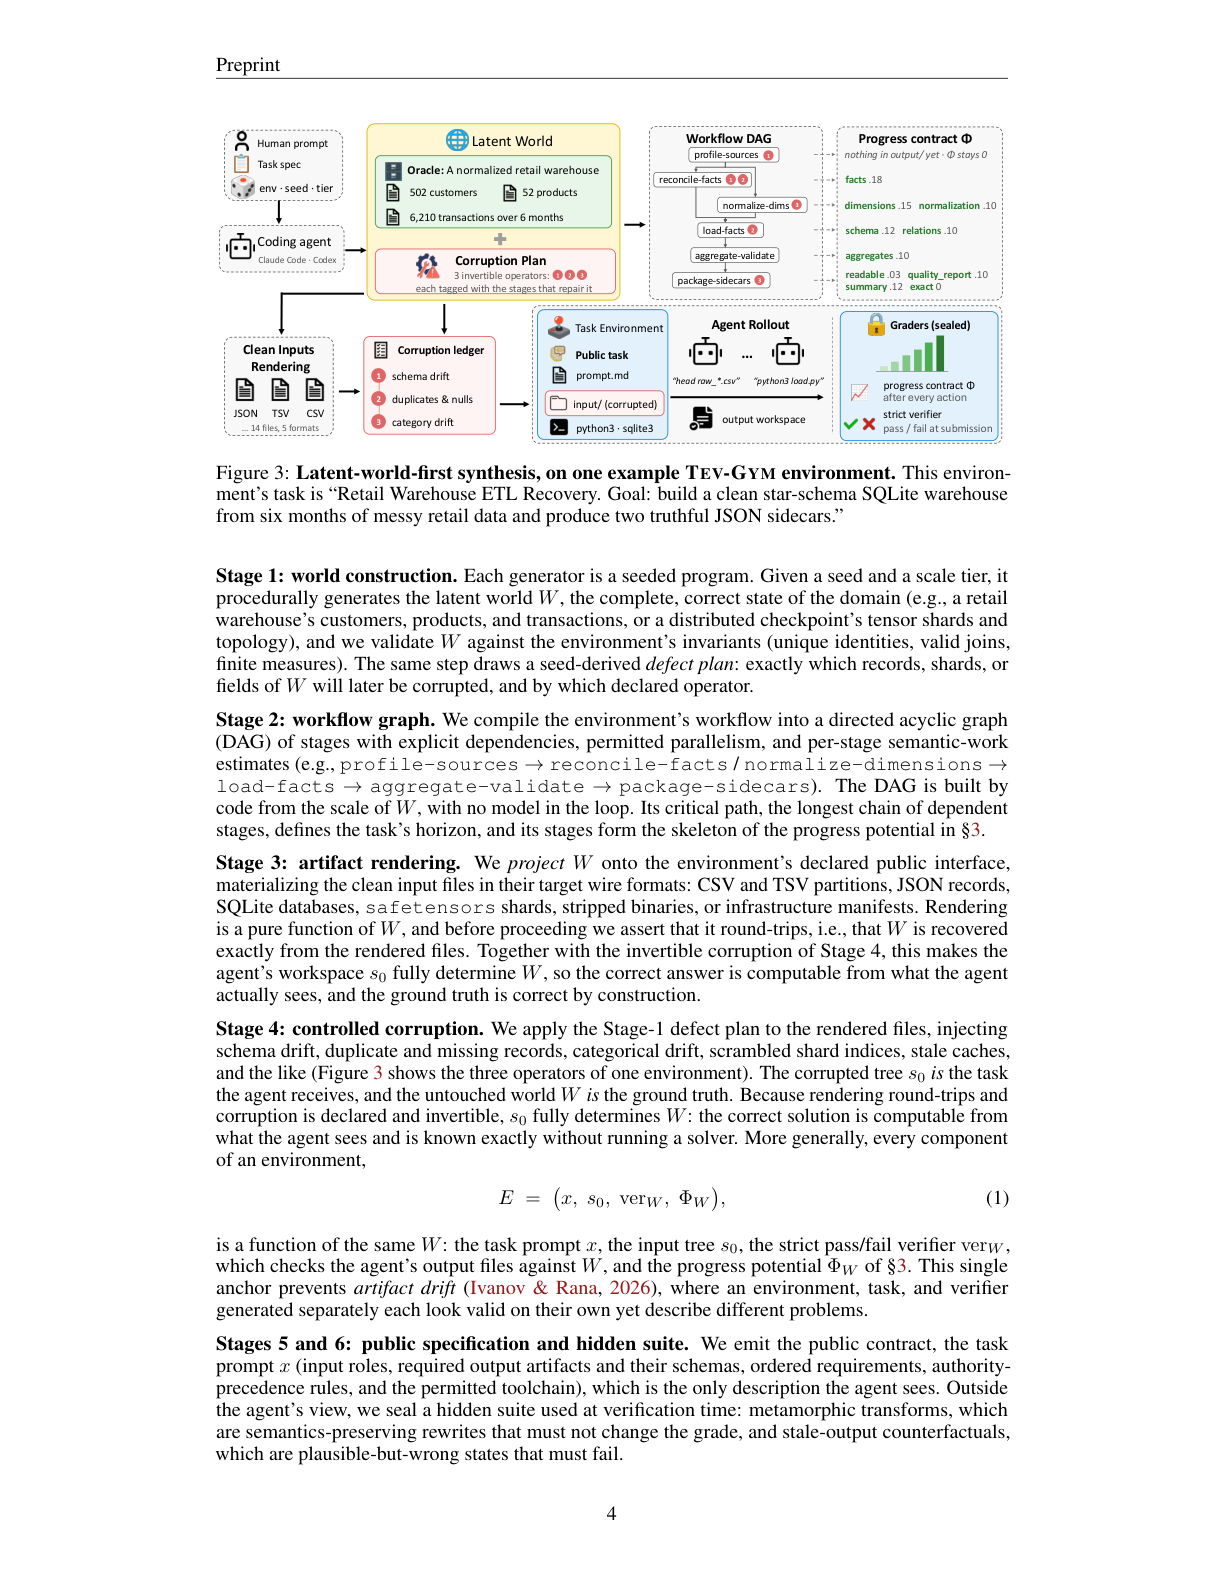
- 先把完好的房子造好(隐世界 W):一个完整、正确、但 agent 看不见的领域状态。比如一个干净的零售数据仓库:502 个客户、52 个商品、6 个月 6210 笔交易。
- 再定破坏计划(corruption plan):声明要往这个世界上打哪些"可逆的缺陷"——schema 漂移、重复记录、缺失值、类别漂移……每个缺陷都标注了由哪些工作流阶段来修复。
- 渲染成题目:把干净世界投影成 agent 看到的输入文件(CSV/TSV/JSON/SQLite/safetensors……),然后按破坏计划污染它。agent 拿到的是
prompt.md+ 一棵被污染的input/目录树 + 一个 bash 工具。 - 因为渲染可往返(round-trip)、破坏可逆且已声明,agent 看到的初始树 s₀ 完全决定了 W——正确答案可以直接从 agent 实际看到的东西里算出来,不需要跑求解器,ground truth 由构造保证正确。
关键点:环境 E = (x, s₀, ver_W, Φ_W) 的四个组件——任务提示词、输入树、严格验证器、进度势能——全是同一个 W 的函数。一个锚点,杜绝了"题目和验证器说的不是一回事"的漂移。
#六个生成阶段(技术版)
| 阶段 | 做什么 | 要点 |
|---|---|---|
| Stage 0 任务源 | 针对每个领域收集真实任务规格(网络挖掘、MLE-bench 的 82 个 Kaggle 竞赛、量子计算用 MQT Bench/Qiskit/TeNPy 公开参考材料) | 只借用结构和难度设计,绝不复用原文/输入/答案/评分器 |
| Stage 1 世界构建 | 种子化程序生成隐世界 W 并校验不变量(唯一标识、有效连接、有限测度),同时抽缺陷计划 | 无模型参与 |
| Stage 2 工作流 DAG | 把环境工作流编译成有向无环图(如 profile-sources → reconcile-facts / normalize-dims → load-facts → aggregate-validate → package-sidecars),每阶段带语义工作量估计 | 关键路径长度 = 任务时程;DAG 节点 = 进度势能的骨架 |
| Stage 3 工件渲染 | 把 W 投影成公开格式的文件,并断言渲染可往返(从渲染文件能精确恢复 W) | 纯函数,由代码构建,无模型在环 |
| Stage 4 受控破坏 | 按缺陷计划注入污染 | 声明过、可逆 → s₀ 完全确定 W |
| Stage 5/6 公开规格 + 隐藏套件 | 给 agent 的公开契约(提示词 x),以及密封的隐藏测试(语义保持变形必须不改分数、陈旧输出的反事实必须挂) | 防验证器过窄、防陈旧状态蒙混 |
#与已有"反向构造"方法的本质区别
"从已知答案反推任务"本身不新鲜:去噪、受控错误注入(BART)、代码变异、指令回译、程序化谜题生成都属于这个家族。但它们都只破坏单个工件(一段文本、一个仓库、一份代码)。TEV 破坏的是一整个世界的渲染,所以任务、验证器、进度信号都是这同一个世界的函数,而不是可能各自漂移的独立生成物。
#一旦写好,规模化几乎免费
每个生成器是一次性由编码 agent 写好、人工审过的确定性种子程序。之后换个 seed 或规模档位就能生成新环境,零模型调用,单个环境(含跑双参考求解器、密封隐藏套件、预览进度势能)中位成本只有 30 秒 CPU 时间。对比人写一条长时程任务的"数周专家时间",这是"写作一次性成本 + 秒级边际成本"的结构。
#TEV-GYM 语料本身
- 1,170 个验证过的环境,7 个领域:软件工程、数据与分析工程、AI/CS 研究、数学与运筹、安全与取证、基础设施与云运维、量子计算。
- 真正长时程:前沿 agent(Gemini 3.6 Flash)每个 rollout 中位 12.4 分钟,是此前最耗时语料的约 6 倍;且难度最高(P@1 29% vs 其他语料 47–83%)。
- 多样性可检验:19 个覆盖轴上的 strength-2 覆盖数组——任意两个轴的每种合法取值组合都至少出现在一个环境里。"多样"是可检查的属性而不是口号,排除了模板锁死(每个轴各自均衡但只以少数固定组合出现)。
- 难度可控:规模档位(unit/small/full)控制世界大小和操作时程,DAG 依赖深度控制"必须按什么顺序做完几件事才能有输出是对的"。
- 八道资格门,全部在生成时自动检查:奖励因果性(改掉某组件的因,该组件分数必须掉)、抗利用(14 种作弊探针全部得 0 分)、角色独立(参考求解器/备用求解器/验证器/进度打分器代码闭包互不相交,谁也不 import 谁)、求解器一致(两个独立求解器必须在所有 seed 上产出相同输出树,否则规格未解决、环境作废)、进度有效性(部分正确状态 0<Φ<1、沿参考轨迹单调升、回归时下降)、变形不变性、六种子多样性、公开契约卫生(提示词和公开树里没有任何私有权威/参考输出/验证器代码)。
| 语料 | 规模 | 领域数 | Agent 时间(min) | Oracle | 打分 | 渐进奖励 | P@1 |
|---|---|---|---|---|---|---|---|
| SWE-Smith | 50.1k | 1 | 2.0 | unit tests | pass/fail | ✗ | 47% |
| Terminal-Universe | 32.0k | 3 | NA | pytest | pass/fail | ✗ | NA |
| TMAX-15K | 14.6k | 3 | 1.3 | unit tests | pass/fail | ✗ | 74% |
| SETA | 4.5k | 4 | 1.2 | unit tests | 测试比例 | ✗ | 80% |
| Endless Terminals | 3.3k | 2 | 0.5 | unit tests | pass/fail | ✗ | 83% |
| CLI-Gym | 1.7k | 4 | 1.9 | unit tests | pass/fail | ✗ | 69% |
| TEV-GYM | 1,170 | 7 | 12.4(中位) | 隐世界 | 分阶段 Φ + pass/fail | ✓ | 29% |
#核心思想二:进度势能与 PPRS
#进度势能 Φ:给"做到一半"打精确分数
每个环境自带一份进度契约:一组可检查的节点 V(来自工作流 DAG),每个节点有权重(和为 1)和前置集合。部分打分器 c_v(s) 直接拿 agent 当前的工作区和隐世界比,输出 [0,1]。关键设计:credit 被前置门控——节点 v 的有效分取它自己和所有直接/间接前置中最低的那个,所以"建立在错误事实表上的正确聚合"一分都拿不到。Φ(s) 就是加权求和。
为什么 Φ 能当训练信号而不被 hack?三道资格门保证:锚定性(未动过的公开树 Φ=0,Φ=1 当且仅当严格验证器通过)、单调性(节点完成则升、毁掉已完成工作则降,回归有负增量)、独立性(打分器与验证器/求解器代码闭包不相交,一个评分器的缺陷不会传染给另一个;打分代码不出现在公开树里)。
这比 process reward model(要人工步骤标注)、学习型裁判、LLM judge 都便宜且精确:因为隐世界在出题前就存在,每个正确的中间状态都能直接渲染出来并被 c_v 精确比对,确定性、无模型、随 seed/规模免费扩展。
#PPRS:经典 reward shaping 的一个"故意不不变"的改造
经典势能塑形(PBRS,Ng et al. 1999)里,每步奖励 = 势能变化 r_t = Φ(s_t) − Φ(s_{t−1}),且把终端势能清零,保证最优策略不变。PPRS 故意保留了终端势能项:
R(τ) = 1[通过] + λ·Φ(s_T) (λ=0.25,所有实验统一,未调参)
为什么不清零?因为清零后所有全败小组的奖励又变成一样的了,§3.1 的饥饿问题原样回归。保留 λΦ(s_T) 相当于故意改变目标函数,换来的是目标"对部分进度有感知"。论文明确交代了代价的边界:确定性策略下排序完全保持(通过的 rollout 得 1+λ > 任何失败者的至多 λ,没人有动机拿"完成"换"部分进度");随机策略的期望排序可能翻转,但只在 p₂−p₁ < λ/(1+λ) = 0.2 且一方失败收尾接近完整、另一方接近空白时才可能发生——而论文汇报的所有结果都是严格验证器下的终端通过率,等于自带对照组。
这个设计里还有一个很干净的细节:提交是一个动作而不是状态。Φ 只给工作区打分;不提交就耗尽 token/回合的 rollout 拿不到终端项、只拿 λΦ(s_T)。"把工作做完了但忘了提交"和"提交了完整工作"由此可区分。又因为 Φ 只看工作区,两条以不同顺序、不同实现到达同一工作区的 rollout 得到相同奖励——不奖励表面的步骤差异,只奖励真实产出。
#它如何救活 GRPO
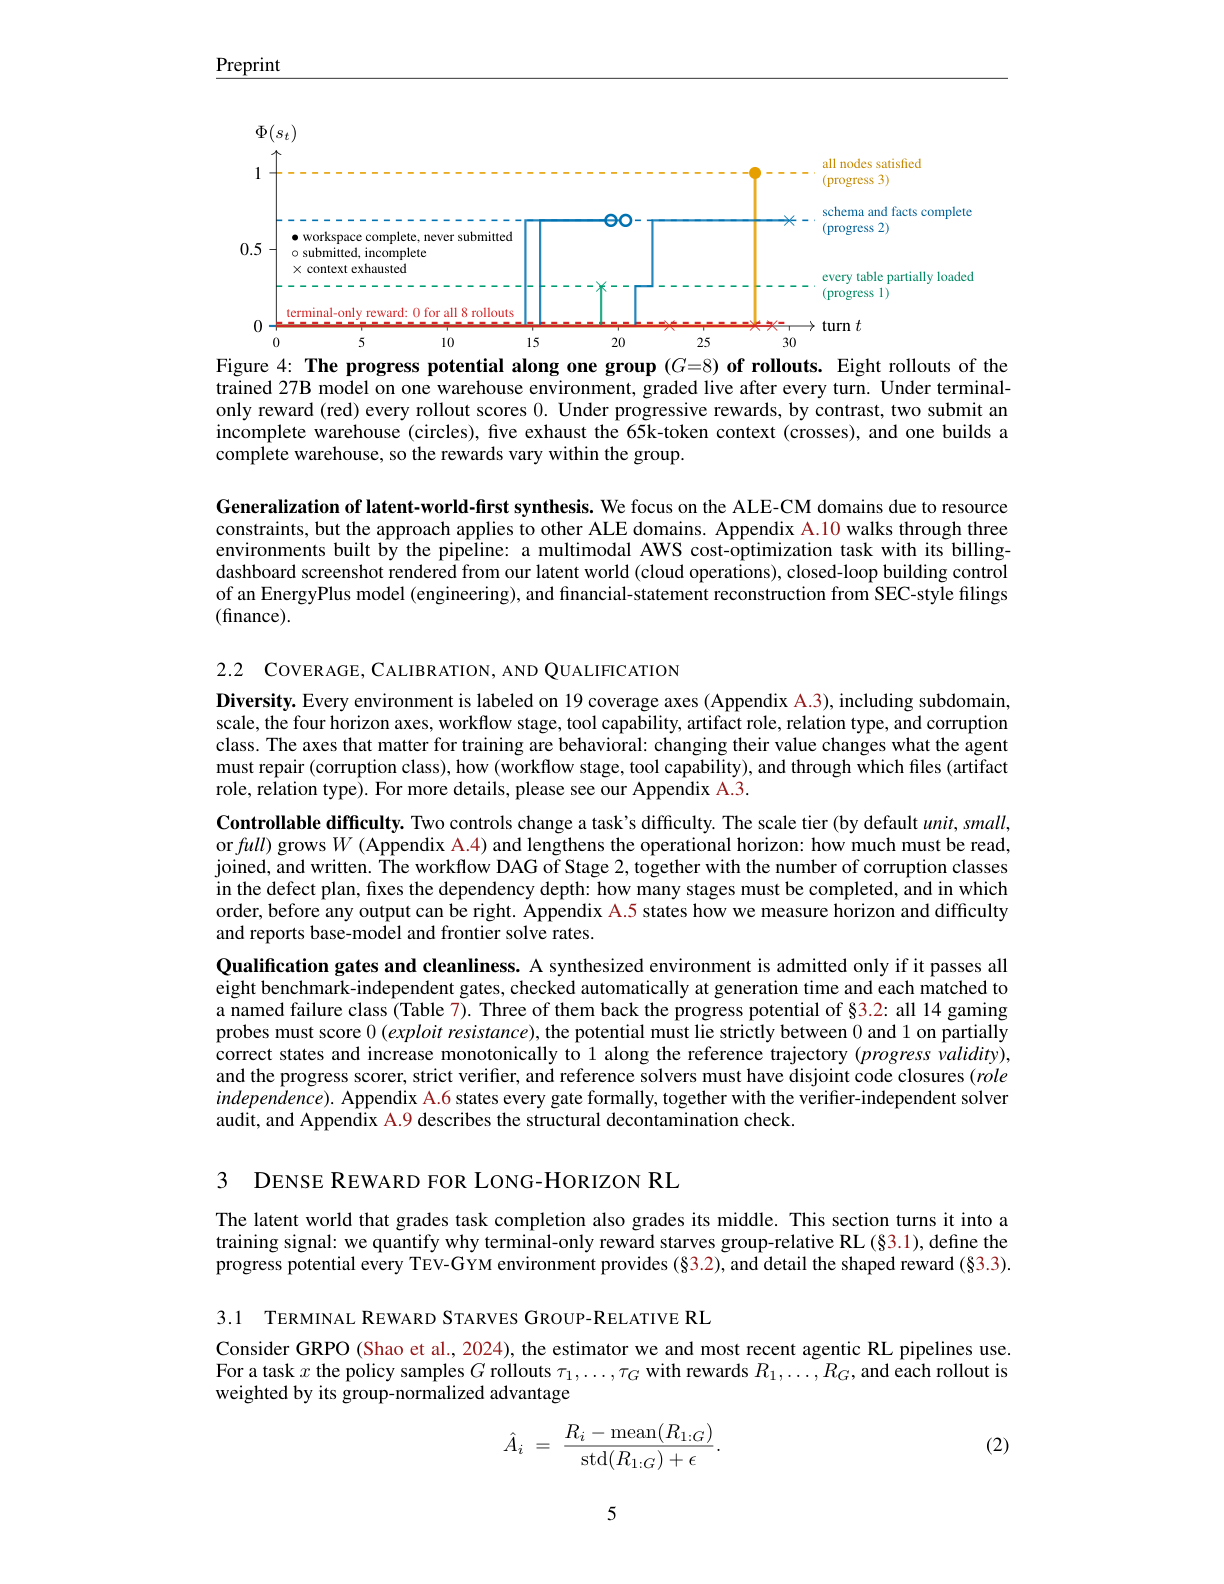
全败小组的奖励变成 R_i = λΦ(s_T^(i)),只要各 rollout 进度深度不同就有组内方差、advantage 非零、按进度排序产生梯度。论文实测了 24 个真实小组(未训练 27B 在仓库环境下 G=8):终端奖励在全部 192 条 rollout 上都是 0,每组的 advantage 都是 0;而用 Φ 看同一批 rollout,每组都有非零方差,rollout 停在 0.05 / 0.26 / 0.69 / 0.78 / 0.90 / 1 的不同阶梯上。而且有成功的小组也受益:唯一的成功者不再和一坨无差别的失败对比,而是和一串有刻度的"差一点"对比,梯度能分辨近似成功和毫无进展。
#训练细节
- 算法 DPPO(组相对优势 + 策略比的总变差散度界 0.1,无 KL 锚);零方差组丢弃并用主动采样补位。
- G=24 rollouts × 8 任务/步 = 每步 192 条 rollout;每条 rollout 预算 65,536 response token(每轮 16,384)、至多 64 次工具调用,单一 bash 工具的容器沙箱。
- credit 分配是按轮次的:第 t 轮拿增量 λr_t,最后一轮额外拿终端项;每轮 advantage 是"从该轮起的 return-to-go(γ=1)减去同轮次索引的组均值"。按轮次归一化是为了不让后期轮次的小回报去和整条 rollout 的均值硬比,γ=1 则把进度传播回早期动作。
- 27B 在 4 节点 B200 或 8 节点 A100 上训约 4 天;9B 用 unit 档的 264 任务子集,27B 用全量。
#结果:小模型打平 frontier 的 Pass@5
ALE-CM(Agents' Last Exam 的计算与数学分域,18 个专家级长时程任务):
- TEV-27B(Qwen3.8-27B 底座):P@5 从 0.17 → 0.28(+65%),追平 GPT-6 Astra 和 Claude Opus 5 的 0.28,达到最强 frontier(Fable 5 的 0.33)的 85%,把原始差距关掉三分之二。
- TEV-9B(Qwen3.5-9B 底座):P@5 提升 83%。
更关键的泛化——只训了 ALE 相关数据,却在更长的时程上继续涨:
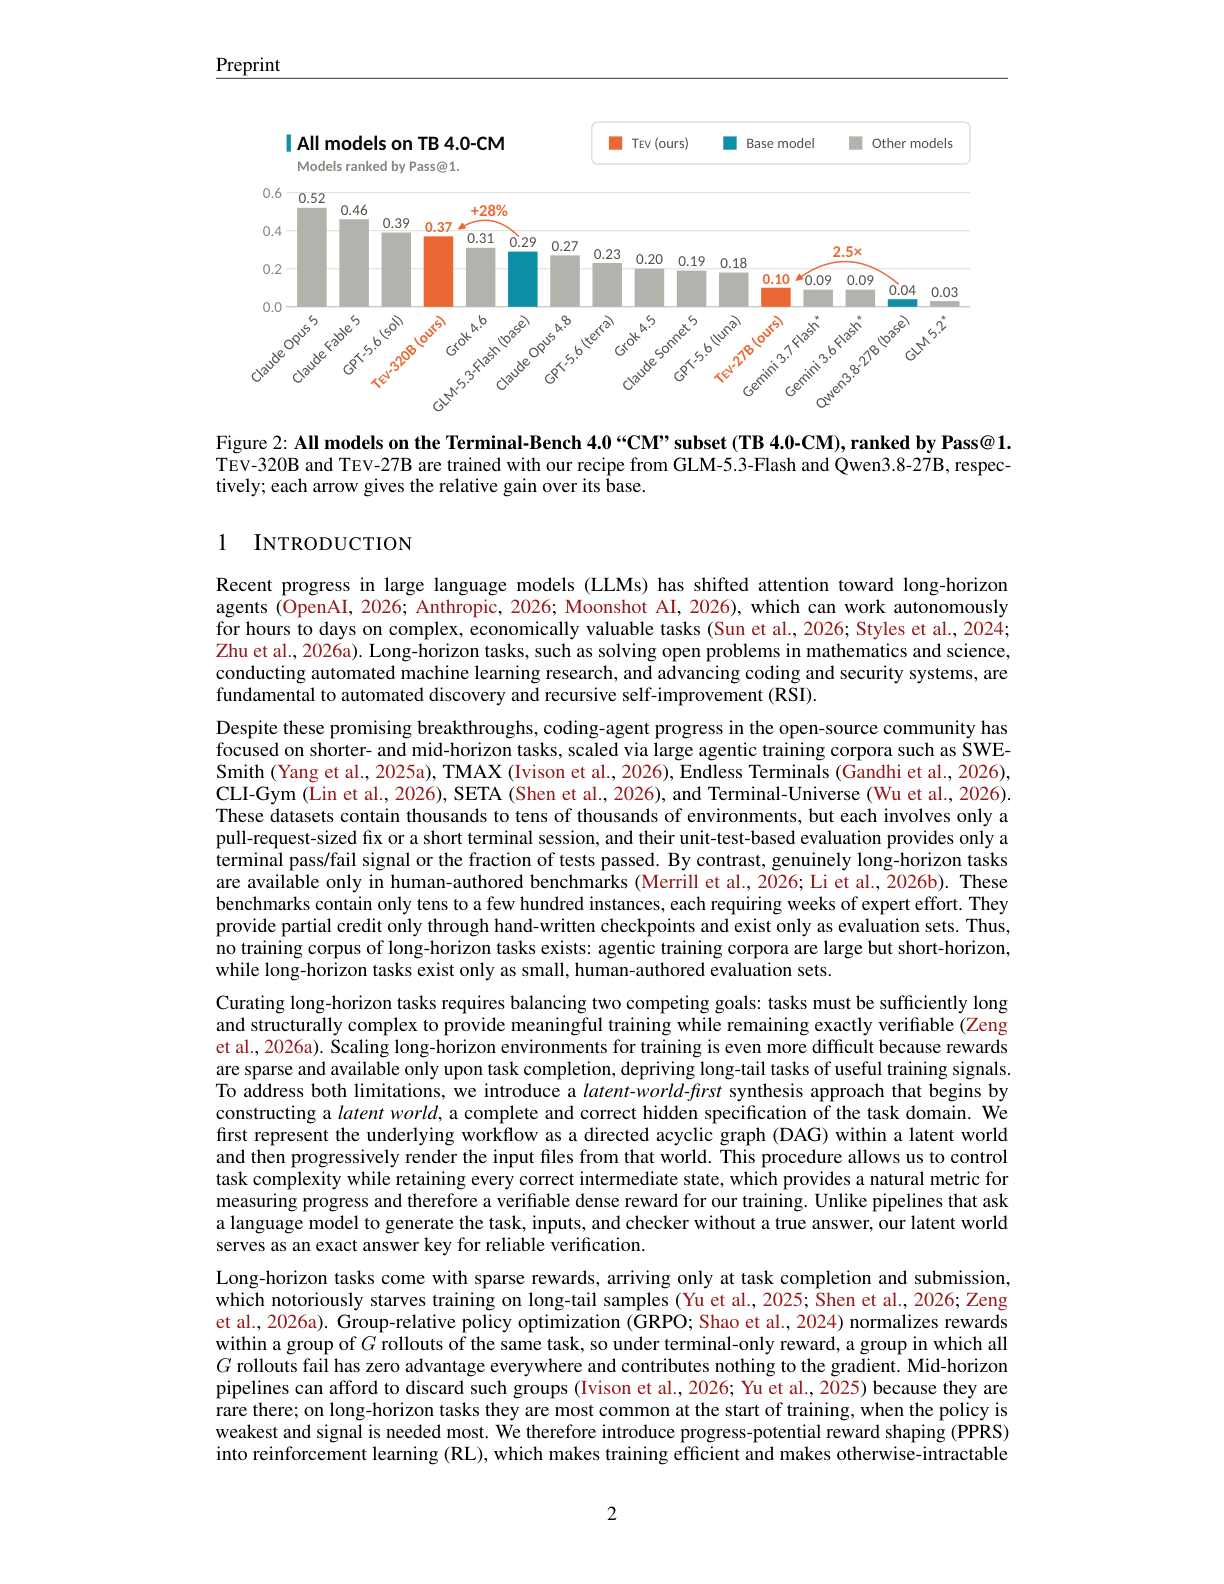
- TB 4.0-CM(每题 8 小时专家工作):P@1 从 0.04 → 0.10(2.5×)。
- TB 3.0-CM:P@1 从 0.09 → 0.14(+56%),超过 GLM 5.2 和 Gemini 3.7 Flash。
- TB 2.1(中时程,零针对性数据):TEV-27B P@1 达 0.794,与 Claude Opus 4.8(0.789)同级;TEV-9B 零样本 P@1 提升 28%——长时程训练正向迁移到中时程。
换更大底座继续成立:同一配方训 GLM-5.3-Flash 得 TEV-320B,TB 3.0/4.0 P@1 再涨 35%/28%(安全类最大:0.22 → 0.45),成为两个子集上最强的开源模型,TB 4.0 上 P@1 只落后 Claude Opus 5、Fable 5 和 GPT-5.6 (sol)。一个有趣观察:提升集中在 P@1 而 P@5 几乎不动——训练主要让模型把够得着的题解得更稳,而不是解锁新题。
训练效率也大幅提升:每步 GPU 时从 22.3(LLM 数据消融)降到 9.0;稀疏奖励在 27B 上根本训不完(几乎全是零 advantage 组,一个优化器步都迈不出去),PPRS 却能训到收敛——密集奖励不只是提速,是"能不能训"的区别。
#消融:两个支柱缺一不可
数据消融(用 GPT-5.6 替换管线中的环节,终端奖励,与 Sparse 行对比):
- 只去掉隐世界真值(让模型从 agent 视角写验证器):88% 的小组在训练中被丢弃,S@1 反而低于底座。
- 完全 prompt-first 自构造基线:同样不涨。
- 完整方法领先两者 0.05–0.06 S@1。结论:LLM 直接合成数据在这个难度档位上不仅没用,甚至负作用;锚定的隐世界 + 隐藏真值才是关键。
奖励消融(数据固定为 TEV-GYM):
- 稀疏(仅终端):不涨。
- PPRS 但按整条 rollout 归一化(pooled norm.):部分指标涨,GPU 成本 10.9。
- 直接加性奖励 Φ(s_t) + 终端(γ=0):与完整版 S@1 打平但更长、更多 rollout 耗尽 context 才提交——反复奖励高势能态而不向后传播 credit,模型学会磨蹭。
- 完整 PPRS(per-turn 归一化 + γ=1):S@1 最好且 GPU-h/step 最低(9.0)。
#论文里三个值得细看的设计细节
- 求解器一致性门是给"规格"做证词,不是给评分器做证词。 参考求解器和备用求解器都不 import 验证器代码,两个独立实现必须在每个 seed 上产出相同的输出树,否则该环境以"规格未解决"为由直接作废。这等于用双重实现排除了题目本身的歧义——比"验证器说是对的就是对的"可靠一个量级。
- 任务子集选择和去污染做得相当干净。 与评测集没有任何 13-gram / 8-gram 重叠(对照组:同一基准内任务彼此共享 156 个 13-gram);最近邻 Jaccard(0.13/0.22)低于同基准任务彼此的相似度(0.24/0.28)。结构上,程序化 seeding 保证没有两个环境共享公开树。TB 3.0/4.0 子集与全基准的 Pearson r = 0.96/0.97。
- 三个完整环境示例(附录 A.10)展示了管线的通用性:多模态 AWS 成本优化(账单截图里的三个 finding 不出现在任何 CSV 里,必须读图)、EnergyPlus 闭环建筑 MPC(隐世界 = 固定版本模拟器 + 声明程序,参考答案在密封镜像里跑一遍程序得到)、SEC 风格财报重建(四个来源对同一行项目给出五个不同值,正确解由声明政策 + 缺陷计划唯一确定)。管线不限于计算与数学域。
#批判性阅读:哪里要打折扣
- 1,170 vs 30k+。 规模小是明面上的事实。作者的理由是"边际成本秒级、可无限换 seed 扩展",且难度和渐进奖励的质量弥补数量。这个论证部分成立(RL 需要的是有效梯度组数量而非任务总数),但每个生成器的一次性撰写与验证成本真实存在,论文也承认"支持新工作流需要撰写和验证新组件"。
- 与 frontier 的差距在 P@1 上仍然巨大。 TB 4.0 上 TEV-320B 的 0.37 对 Claude Opus 5 的 0.52;作者自己说"需要更强的开源底座才能完全受益于这套高质量但困难的 TEV-GYM"。
- 评测集很小。 ALE-CM 只有 18 个任务、TB 4.0-CM 只有 18 个,"追平 GPT-6 Astra 的 Pass@5"建立在 5 次 rollout 的 best-of-5 上,绝对数字的置信区间不宽。子集代表性有相关性佐证(r≈0.96+),这是合理的防御,但不是免疫。
- 只在合成终端环境上验证。 论文自己列为第一局限。真实软件仓库、真实生产系统的长时程任务是否服从同样的"隐世界可构造"假设,仍待检验。
- "匹配 GPT-6 Astra 和 Claude Opus 5"只发生在 Pass@5。 Pass@1 上 TEV-27B(0.16)与 frontier(0.28)仍有清晰差距。标题级表述比论文正文谨慎。
- λ=0.25 未调参是美德也是潜在隐患——论文给了随机策略下排序翻转的理论界(≤0.2 的通过率差 + 失败收尾接近完整),但没系统扫描 λ。
#为什么这篇论文对长时程 Agent RL 特别重要
这篇论文在一个正变得拥挤的方向(agent 环境合成)里做了三件真正区分度高的事:
- 把"反向构造"从单个工件升级到整个世界。 单工件反向构造(bug 注入、去噪、回译)是老技术;"渲染可往返 + 声明式可逆破坏 → s₀ 完全决定 W"这一步,让任务、验证器、进度信号共享一个真值锚点,是对 artifact drift 的结构性解法,不是又一个数据 pipeline。
- 把 GRPO 饥饿问题当作一等公民来解。 大量近期工作用"丢废组 / 挑能力边缘任务 / 加专家前缀"绕开稀疏奖励,那些方法默认 p 不至于太小。TEV 面对的是 p=0.03 的真实长尾,给出的答案不是简化任务、不是搭脚手架,而是保持任务和 harness 不变、提高奖励的分辨率——这个立场本身就是对 "curriculum-first" 范式的一次反驳,值得记住。
- 密集奖励不需要学习型组件。 Φ 是确定性的、免模型的、构造即正确的。对照当下流行的 PRM / LLM-judge 路线,这是"可验证奖励"哲学在过程层面的一次彻底延伸:如果题目是从已知世界反向构造的,那么过程监督也是免费且可验证的。 它与 test-pass 比例(SETA)的差别在于 Φ 有回归概念、且独立于终端测试所探查的东西。
对正在研究长时程 Agent RL / model-based RL / 数据合成的人来说,两个可带走的判断:(a)"先有答案再造题"不只是防作弊技巧,它是把过程奖励也变成可验证构造的钥匙;(b)在 p 极低的任务上,奖励分辨率(而不是任务数量)是训练能否启动的第一瓶颈。这两个判断都适用于 LLM agent 之外的一般 RL 设定。
#附:论文与相关工作的坐标
- 论文:arXiv:2610.18868,Wenbo Hu, Shraman Pramanick, Krishna Kumar Singh, Nanyun Peng, Kai-Wei Chang, Yong Jae Lee(Adobe Research & UCLA)。
- 评测:Agents' Last Exam(ALE)、Terminal-Bench 2.1/3.0/4.0。
- 数据对比对象:SWE-Smith、TMAX、Endless Terminals、CLI-Gym、SETA、Terminal-Universe。
- 奖励塑形理论根基:Ng et al. 1999(PBRS),PPRS 是其"故意非不变"变体。
- 相关近期方向:SPA-RL(逐步归因)、verifiable process rewards、Enigmata / REASONING GYM(程序化谜题合成)、ZPD 难度对齐的环境合成。